Quand 'Down' n'est pas 'Gone' : Concevoir une dégradation gracieuse pour des dépendances numériques concentrées
La plupart des rapports de panne commencent par une question binaire : le service est-il opérationnel ou hors service ? Des incidents récents dans divers secteurs soulignent une question plus utile pour les responsables de la technologie, des risques et des opérations : quels résultats clients fonctionnent encore lorsque une dépendance partagée échoue, et comment l'organisation saura-t-elle quand la récupération est vraiment complète ?
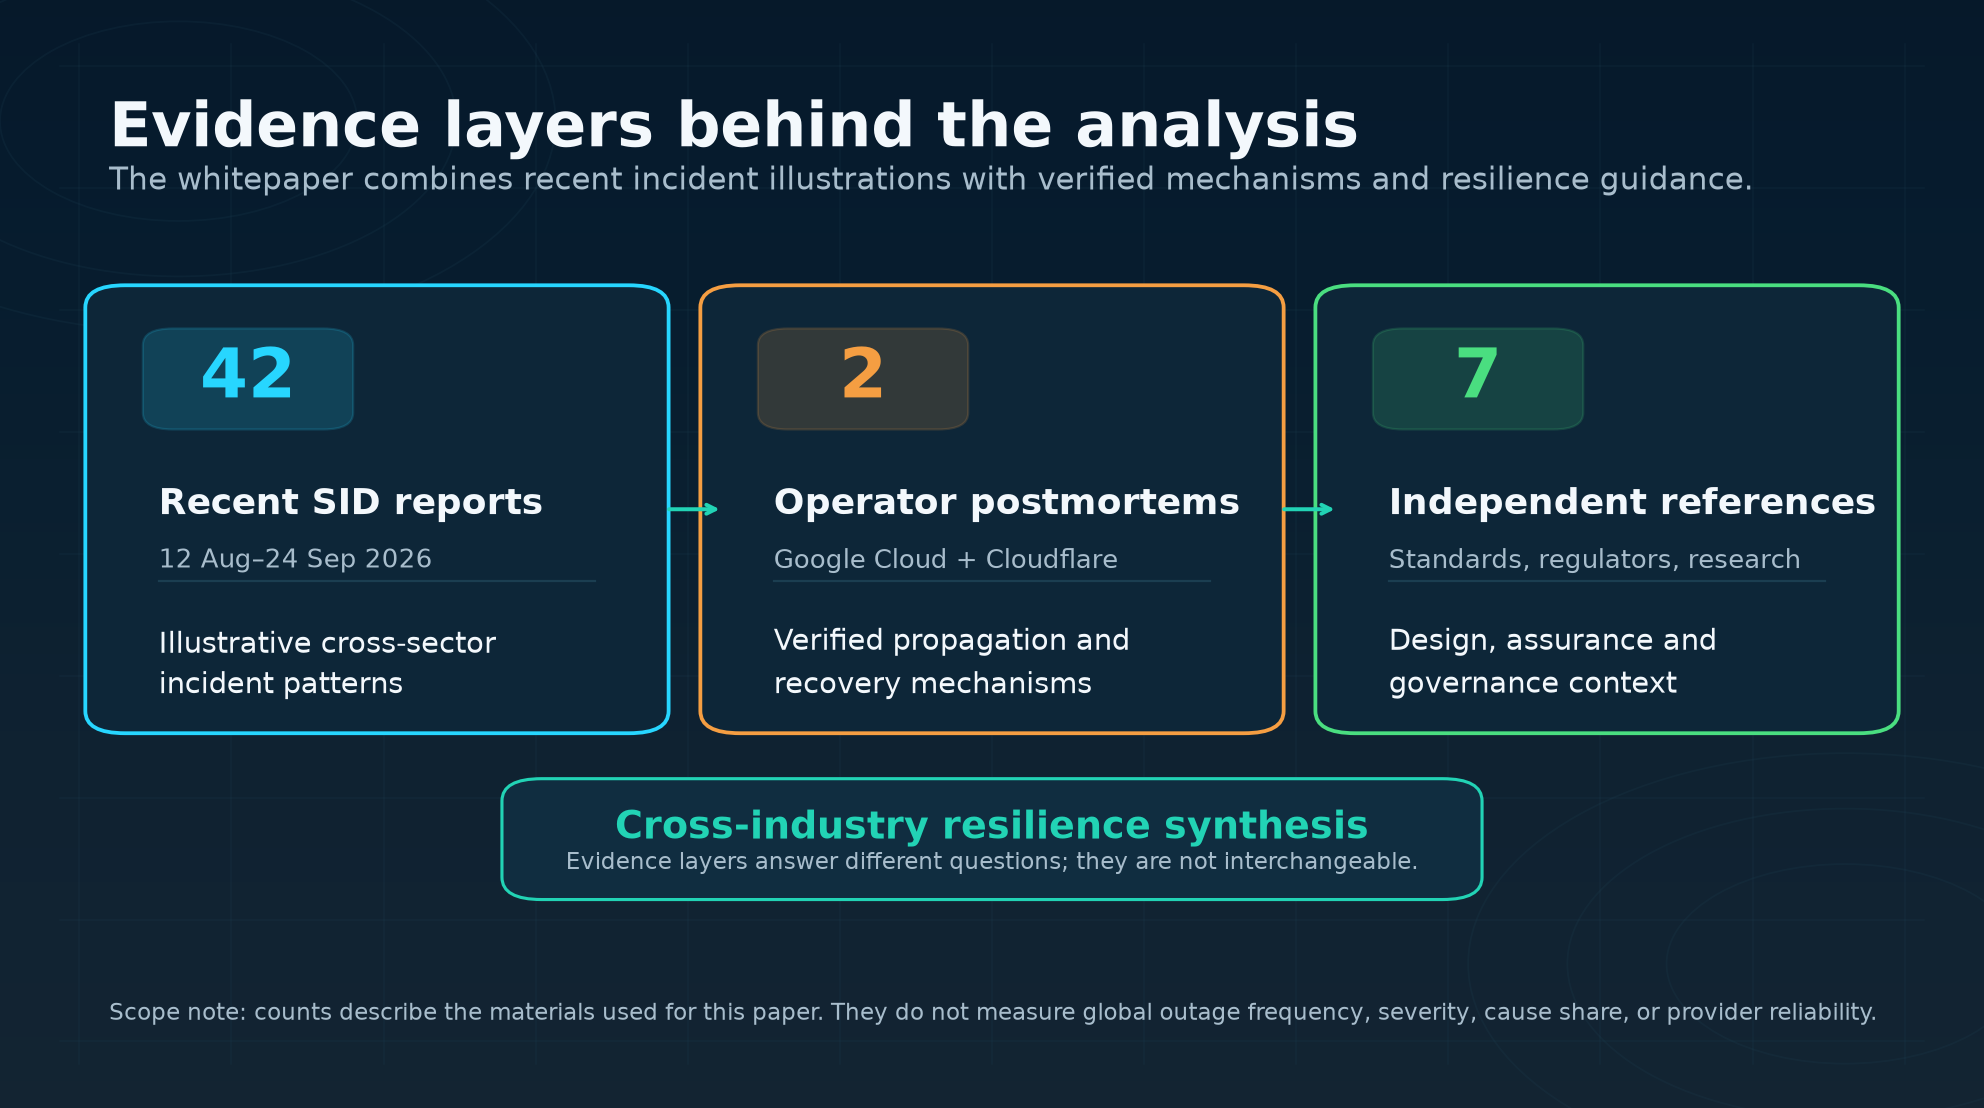
Ce livre blanc examine un corpus éditorial de 42 publications de Status Is Down publiées du 12 août au 24 septembre 2026, puis compare ces illustrations avec les post-mortems des opérateurs et les conseils réglementaires ou normatifs. Le corpus n'est pas un ensemble de données global sur les pannes représentant statistiquement, donc il ne peut établir la fréquence des incidents, la fiabilité comparative ou une cause dominante. Il peut cependant mettre en lumière des questions de conception récurrentes à travers les plateformes cloud, les télécommunications, la banque, les communications d'urgence et le transport.
La découverte centrale est que la concentration efficace des dépendances peut transformer une défaillance étroite de contrôle, environnementale, de routage, d'identité ou de traitement en un incident multi-produit. La dégradation gracieuse peut réduire cette exposition en préservant un service minimal défini, sûr et clairement communiqué. La résilience doit donc être évaluée par rapport aux résultats critiques et à la normalisation vérifiée - et non par un nombre de fournisseurs, un pourcentage de disponibilité unique ou le moment où un fournisseur en amont affiche "résolu".
Résumé exécutif
La dépendance la plus importante d'une organisation n'est pas toujours son fournisseur le plus visible. Il peut s'agir d'un chemin d'authentification partagé, d'un système de distribution de configuration, d'un processeur central, d'une installation de refroidissement de centre de données, d'un circuit porteuse, d'une plateforme de statut ou d'un canal de support. Ces fonctions forment un noyau de dépendance efficace : un ensemble restreint de domaines de défaillance qui peuvent interrompre simultanément plusieurs services de marques ou parcours clients.
La dégradation gracieuse est le contrepoids pratique. Cela signifie préserver délibérément un résultat limité, sûr et intelligible lors d'une défaillance. Cela ne signifie pas accepter passivement un service de qualité inférieure, en supposant qu'un canal alternatif fonctionne pour chaque client, ou déclarer un succès alors que des files d'attente et des travaux de réconciliation s'accumulent. Le mode dégradé nécessite des limites claires en termes de capacité, d'intégrité et de communication avec les clients, suivies d'un retour vérifié à un fonctionnement normal.
| Question de résilience | Preuves que les responsables devraient exiger |
|---|---|
| Où est la dépendance concentrée ? | Une carte des domaines de défaillance logiques, physiques, administratifs et tiers - pas seulement une liste de fournisseurs. |
| Qu'est-ce qui reste utilisable en toute sécurité ? | Un service minimal testé pour chaque résultat client ou public important, avec des limites et des alternatives indiquées. |
| Quand la récupération est-elle complète ? | Des preuves que les arriérés, l'intégrité des données, le service régional, les canaux de support et les flux de travail dépendants ont été normalisés. |
Où se cache la concentration
La concentration logique peut être aussi conséquente qu'un câble endommagé ou une alimentation électrique défaillante. Dans le rapport Microsoft 365 et ChatGPT Work de Status Is Down, Microsoft a attribué l'impact continu à un problème de configuration central d'authentification qui a atteint Exchange Online et les services de collaboration et de sécurité connectés. L'événement ChatGPT décrit dans le même article était séparé ; la proximité temporelle n'établissait pas une cause commune. Un rapport multi-fournisseurs sur l'IA ultérieur a appliqué la même protection : les incidents de produits simultanés n'étaient pas la preuve d'une défaillance commune du cloud.
Deux post-mortems de première partie montrent comment la propagation peut amplifier un changement restreint. Google Cloud a rapporté que des champs vides involontaires dans les données de politique de quota se sont reproduits globalement en quelques secondes, exploitant un chemin de code de contrôle de service insuffisamment protégé et provoquant des boucles de plantage. La plupart des régions ont commencé à récupérer après la désactivation du chemin de politique, tandis qu'un effet de troupeau de redémarrage a prolongé la récupération dans une grande région et certains produits avaient des arriérés résiduels. Google a également déclaré que certaines infrastructures de santé et de surveillance des clients étaient affectées.
Cloudflare a quant à lui retracé son incident de novembre 2025 à un changement de permission de base de données qui a doublé le fichier d'une fonctionnalité de gestion de bots. Le fichier surdimensionné s'est propagé à travers le réseau et a dépassé une limite logicielle. Cloudflare a explicitement rejeté l'hypothèse d'une cyberattaque. Le trafic principal était essentiellement normal à 14h30 UTC, mais tous les systèmes n'ont pas été déclarés normaux avant 17h06 UTC. Ces mécanismes n'expliquent pas les incidents de 2026 ; ils démontrent pourquoi la génération de configuration, la validation, le déploiement, le retour en arrière et l'observabilité appartiennent au modèle d'échec de production.
La concentration physique et opérationnelle peut également défaire une sauvegarde nominale. Dans l'incident de télécommunications de l'aéroport du Nord-Est, un circuit de communication principal a échoué tandis qu'une route de fibre de secours était également indisponible après avoir été coupée. Les réparations ont permis la reprise des opérations, mais des perturbations accumulées des vols sont restées. Une deuxième ligne sur un schéma n'est pas une preuve de résilience si elle partage un couloir, une installation, un plan de contrôle, une source d'alimentation ou une contrainte de réparation avec la première.
Un service partiel n'est pas équivalent à la disponibilité
Les cas financiers montrent pourquoi les résultats clients devraient être évalués séparément. Lors d'une altération d'application au Royaume-Uni, le rapport Monzo a décrit un arrangement indépendant de banque de secours et des paiements par carte, des retraits d'argent, des gels de carte et des transferts tandis que certaines fonctions de l'application étaient limitées. Dans l'incident NAB, la banque numérique, le trading et le contact téléphonique étaient affectés, tandis que les distributeurs automatiques et les paiements rapides restaient disponibles et qu'une date limite pour les entrées directes a été prolongée. Aucun de ces exemples ne signifie que chaque client avait un substitut adéquat ; cela montre qu'une organisation peut concevoir la continuité autour de tâches spécifiques plutôt qu'un unique front end.
Les dépendances partagées peuvent produire un impact inégal. Le rapport sur les processeurs Mastercard de Status Is Down a documenté différents états de processeurs et de routes, sans revendiquer un échec de paiement universel ou une cause technique finale. Le rapport Sharetec a décrit une disruption spécifique aux institutions après que des caisses de crédit affectées ont attribué l'incident à des problèmes de refroidissement et de basculement chez un fournisseur de services centraux partagé. La restauration centrale ne signifiait pas automatiquement que les soldes, la banque numérique et chaque flux de travail de membre étaient réconciliés en même temps.
Ce cadre orienté résultats se reflète dans CPS 230 de l'APRA. Pour les institutions australiennes réglementées, cela nécessite des tolérances pour la perturbation maximale, la perte de données et le service minimal dans le cadre d'arrangements alternatifs pour des opérations critiques. Le FFIEC appelle également à une analyse des points de défaillance uniques et des dépendances à travers le traitement central, la banque en ligne et mobile, le règlement, les services publics et les tiers. Ce sont des exigences et des directives spécifiques au secteur, pas des règles juridiques universelles, mais le principe de conception est largement applicable : définissez la tâche qui doit se poursuivre avant de choisir la sauvegarde.
Les communications d'urgence et le transport exposent le risque spécifique aux chemins
La communication d'urgence n'est pas un chemin unique. Le rapport Oklahoma 911 a distingué l'achèvement des appels filaires des problèmes de routage sans fil et a décrit les lignes et transferts alternatifs à dix chiffres utilisés pendant la perturbation. Il n'a pas établi que chaque centre d'appel de l'Oklahoma avait échoué simultanément, et aucune source examinée n'a fourni un total d'appels échoués ou une cause racine plus spécifique. Un soin similaire est nécessaire chaque fois que la voix, le texte, les données de localisation, le routage et la livraison des centres d'appels locaux ont des états différents.
Aux États-Unis, la FCC exige que les fournisseurs couverts complètent les appels 911, transmettent des informations de localisation, abordent la diversité des circuits, la puissance de secours et la surveillance, et informent les installations 911 affectées des pannes qui peuvent les affecter. Ces règles sont spécifiques à la juridiction. Pendant toute perturbation active des services d'urgence, les lecteurs doivent suivre les instructions actuelles de l'autorité locale concernée plutôt que de traiter une page de suivi générale ou de nouvelles comme un substitut.
Les systèmes de transport rendent la queue de récupération visible. Des communications rétablies peuvent rouvrir un chemin d'exploitation tandis que les avions, les équipages et les passagers restent mal positionnés. Les infrastructures ferroviaires réparées peuvent permettre un service tandis que des retards résiduels persistent. La leçon n'est pas que chaque incident de transport partage une cause amont; c'est que le statut de l'actif permettant et le statut du résultat public sont des faits opérationnels différents.
La récupération est une séquence, pas un étiquette
Un langage de récupération précis réduit les faux rassurances et facilite la vérification. Un modèle pratique en quatre étapes est :
- Confinement : la défaillance est isolée ou sa propagation est arrêtée.
- Capacité minimale rétablie : un résultat critique défini ou un chemin alternatif sûr est disponible dans ses limites énoncées.
- Normalisation en cours : les files d'attente, les travaux retardés, la capacité régionale, le support client, la cohérence des données et les flux de travail dépendants sont nettoyés ou vérifiés.
- Récupération déclarée complète : l'intégrité et le statut opérationnel normal ont été vérifiés par rapport à des critères de fermeture explicites.
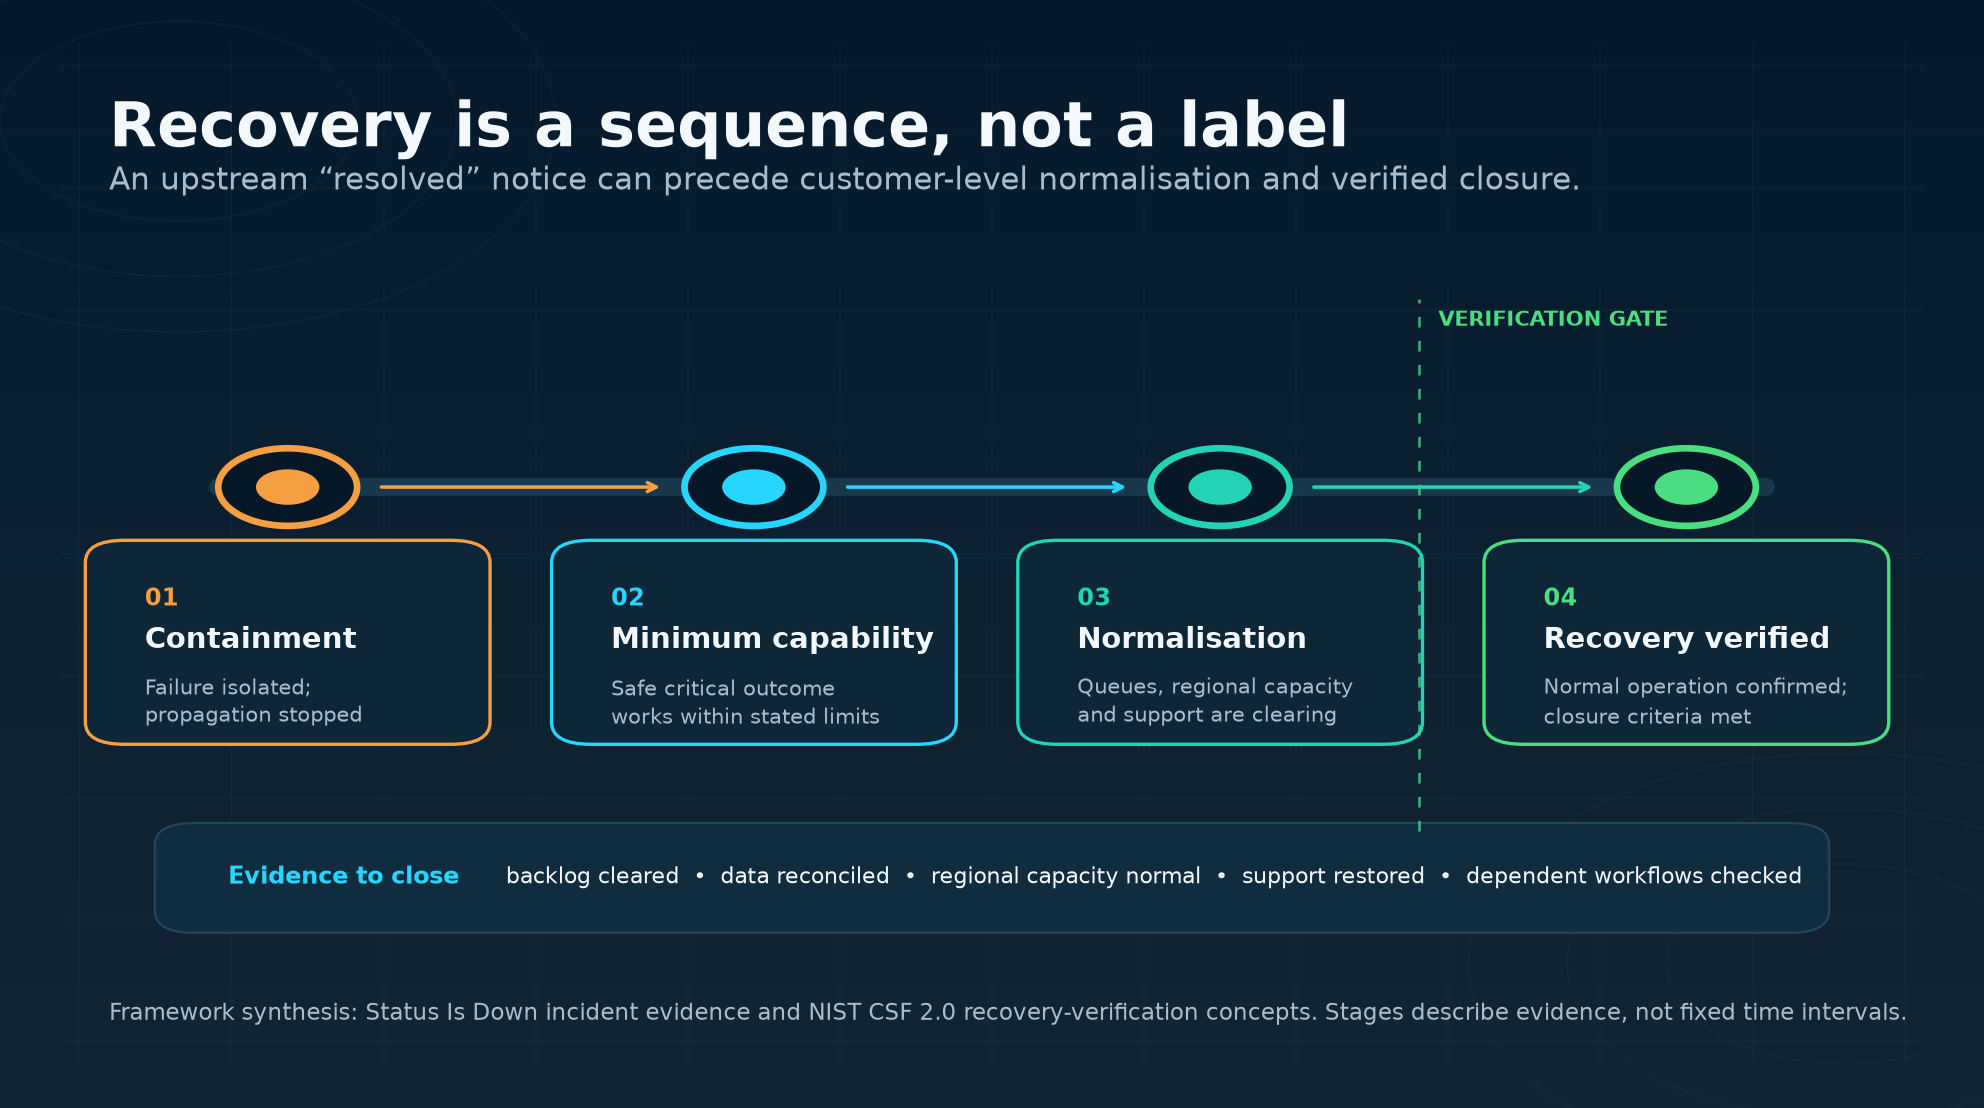
Cette distinction apparaît dans les preuves des incidents. J:COM a rapporté une récupération de service énuméré tandis que les appels au centre client restaient difficiles. La réparation de télécommunications de l'aéroport a permis aux opérations de reprendre avant que les horaires ne se normalisent. Google Cloud et Cloudflare ont tous deux enregistré un écart entre la récupération large ou centrale et la fin des effets résiduels.
Le NIST Cybersecurity Framework 2.0 formalise l'étape de vérification pour les incidents cyber : les actions de récupération sont sélectionnées et prioritaires, les actifs de restauration sont vérifiés, l'intégrité des actifs restaurés et le statut opérationnel normal sont confirmés, et la fin de la récupération est déclarée selon des critères. La même discipline est utile au-delà de la cybersécurité, même lorsque l'incident commence par une panne d'alimentation, un refroidissement, des télécommunications ou une erreur opérationnelle.
Un programme en cinq parties pour une dégradation gracieuse
Tout d'abord, cartographiez le résultat important et chaque domaine de défaillance qui l'active. Suivez l'identité, le DNS, la livraison de périphérie, les plans de contrôle, les API, les processeurs, les centres de données, les transporteurs, la surveillance et le support, y compris les quatrièmes parties et les itinéraires physiques. Le cadre DORA de l'UE considère la concentration tierce des TIC critiques comme une préoccupation de résilience opérationnelle en finance; d'autres secteurs peuvent utiliser la même lentille analytique sans supposer que la réglementation s'applique à eux.
Deuxièmement, définissez le mode viable minimum. Énoncez quelles tâches client continuent, quelles données peuvent être retardées, qui reçoit la priorité, quelle limite de capacité s'applique et comment le travail différé sera réconcilié. Une alternative qui est dangereuse, inaccessible ou trop petite pour la demande n'est pas un service dégradé crédible.
Troisièmement, concevez le confinement et le basculement. Selon le système, les contrôles peuvent inclure des déploiements échelonnés, des validations, des drapeaux de fonctionnalité, des interrupteurs d'arrêt, des reprises limitées, des retards exponentiels aléatoires, des disjoncteurs, des files d'attente, des caches, des politiques de session et des solutions manuelles. Le post-mortem de Google a identifié plusieurs de ces domaines comme des zones de remédiation ; le jeu de contrôles exact doit s'adapter au service et à son risque.
Quatrièmement, préservez l'observabilité indépendante et la communication. La page de statut, la pile de surveillance et le canal de support peuvent partager la même dépendance que la production. Les organisations doivent identifier un moyen distinct d'observer les résultats clients et publier des mises à jour approuvées qui distinguent les symptômes, la portée confirmée, le statut de la cause, les solutions de contournement, la restauration des capacités, la normalisation et la clôture.
Cinquièmement, exercez la défaillance combinée. Les directives de résilience opérationnelle de la FCA demandent aux entreprises concernées de cartographier les personnes, les processus, la technologie, les installations, les informations et les tiers, puis de tester des scénarios sévères mais plausibles. Elles distinguent également les objectifs de temps de récupération des tolérances d'impact et notent que les actions de réponse peuvent acheter du temps pendant que la récupération se termine. Un exercice utile devrait donc tester la perte de dépendance, le service partiel, l'absence de communications normales, la surcharge de support et le nettoyage des arriérés ensemble - pas seulement si un serveur de sauvegarde démarre.
Mesures que les conseils peuvent utiliser
Un seul pourcentage de disponibilité ne peut pas montrer si un client a complété un paiement, atteint les services d'urgence, s'est enregistré pour un vol ou accès à une fonction critique de compte. Les mesures orientées résultats peuvent inclure le temps de détection, le temps jusqu'à la première contingence utilisable, le pourcentage ou le volume des tâches critiques complétées en toute sécurité, l'âge des files d'attente, les exceptions de réconciliation, la disponibilité des canaux de support, le temps jusqu'aux opérations normales vérifiées et les risques de récupération non résolus.
L’analyse 2026 de l’Uptime Institute fournit un contexte plus large : elle rapporte que la fréquence des pannes par site a diminué pour la cinquième année consécutive, tandis que les pannes d'infrastructure externe sont devenues plus visibles dans les pannes publiquement rapportées. Les incidents de fibre et de connectivité étaient plus susceptibles de produire des perturbations prolongées. Ses preuves combinent des enquêtes, des rapports publics, des membres, des partenaires et sa propre base de données. Ces résultats ne devraient pas être traités comme un recensement du corpus de Status Is Down, mais ils renforcent la nécessité de regarder au-delà des équipements internes et de cartographier les dépendances externes.
Ce que cela signifie pour les utilisateurs de Status Is Down
Status Is Down peut soutenir ce travail en aidant les équipes à comparer les signaux utilisateurs actuels avec les mises à jour des opérateurs à travers ses dossiers sur le site web, annuaire des services et tableau de bord en temps réel. Ces ressources complètent, plutôt que de remplacer, les instructions officielles du fournisseur, d'urgence ou de transport.
Créer un compte et sélectionner un plan de suivi peut aider les équipes à suivre les services externes dont elles dépendent et à ajouter un contexte à leur propre télémétrie. La tâche de résilience plus importante reste organisationnelle : définissez le résultat critique, testez le mode dégradé et vérifiez le chemin de retour à la normale. Les lecteurs peuvent également explorer des recherches supplémentaires dans la collection des Documents blancs sectoriels.
Méthodologie et limites
Le matériel de Status Is Down utilisé ici est un corpus éditorial sélectionné, lié aux sources, et non une étude de prévalence. Les comptages d'articles ne peuvent pas soutenir des revendications sur la fréquence, la gravité, la géographie, la durée, la fiabilité comparative ou la part des causes racines. Des rapports contemporains peuvent également être révisés par des analyses ultérieures des opérateurs. Le langage de cause reste donc étroit : confirmé lorsqu'un post-mortem existe, attribué lorsqu'un opérateur ou une institution a fourni un compte rendu, et non divulgué lorsque les preuves n'ont pas établi plus.
La simultanéité n'est pas la causalité. Des symptômes similaires ou un chronométrage chevauchant ne prouvent pas une défaillance partagée du cloud, du transporteur, d'une cyberattaque, d'un acte de sabotage ou d'une défaillance du fournisseur. Une disponibilité partielle n'est pas non plus une preuve d'innocuité : un DAB, une route par carte, un numéro alternatif ou un canal textuel peuvent avoir des limites d'éligibilité, de capacité, d'accessibilité ou géographiques. Enfin, les sources réglementaires dans ce document décrivent leurs propres secteurs et juridictions et ne devraient pas être interprétées comme des conseils juridiques.
Conclusion
Un service résilient ne promet pas que chaque composant restera disponible pour toujours. Il rend visibles les limites de dépendance, limite le rayon d'explosion, préserve des résultats critiques définis là où c'est sûr, communique ce que les utilisateurs peuvent et ne peuvent pas faire, et déclare la récupération complète seulement après vérification. Pour les dirigeants examinant les tendances récentes des pannes, la dégradation gracieuse n'est pas une version atténuée du temps de fonctionnement ; c'est la discipline opérationnelle qui transforme des dépendances concentrées en un risque délimité et mesurable.
Sources
- Status Is Down : La panne de Microsoft 365 laisse un petit sous-ensemble affecté jusqu'au troisième jour; ChatGPT Work se remet après une interruption de cinq heures
- Status Is Down : Les pannes de ChatGPT et Claude touchent les utilisateurs d'IA alors que les rapports se répandent à travers Gemini, Copilot et Grok
- Status Is Down : Cuba commence à récupérer son réseau après une panne nationale; la panne de Sharetec perturbe les caisses de crédit
- Status Is Down : J:COM restaure le haut débit après une large perturbation au Japon ; NAB résout une panne de banque numérique
- Status Is Down : Les opérations de l'aéroport du Nord-Est reprennent après une panne de télécommunications ; la reprise de l'entreprise de l'État du Michigan se poursuit
- Status Is Down : Pannes de paiement de Mastercard dans le monde : cinq processeurs rapportent des erreurs avant que la récupération ne commence
- Status Is Down : Monzo active une banque de secours en pleine panne d'application au Royaume-Uni ; un bogue de réservation d'IndiGo bloque les réservations en Inde
- Status Is Down : Oklahoma restaure le routage 911 après un problème de réseau ; des poteaux tombés perturbent le service ferroviaire de Long Island
- Google Cloud : Plusieurs produits GCP rencontrent des problèmes de service
- Cloudflare : Panne de Cloudflare le 18 novembre 2025
- Uptime Institute : Rapport d'analyse des pannes annuelles 2026
- Institut national des normes et de la technologie : Le cadre de cybersécurité NIST 2.0
- Autorité de conduite financière : Résilience opérationnelle : informations et observations pour les entreprises
- Commission fédérale des communications : Fiabilité du 911
- Autorité australienne de régulation prudente : Norme prudente CPS 230 Gestion des risques opérationnels
- Autorité européenne des assurances et des régimes de retraite professionnels : Loi sur la résilience opérationnelle numérique (DORA)
- Conseil fédéral des institutions financières : Gestion de la continuité des affaires : Analyse d'interdépendance
Crédit d'image : Illustration générée pour Status Is Down