Wanneer 'Down' niet 'Verdwenen' is: Het Ontwerpen van Gracieus Verlies voor Geconcentreerde Digitale Afhankelijkheden
De meeste storingsrapporten beginnen met een binaire vraag: is de dienst up of down? Recente incidenten in verschillende sectoren wijzen op een nuttigere vraag voor technologie-, risico- en operationele leiders: welke klantresultaten functioneren nog steeds wanneer een gedeelde afhankelijkheid faalt, en hoe zal de organisatie weten wanneer het herstel daadwerkelijk volledig is?
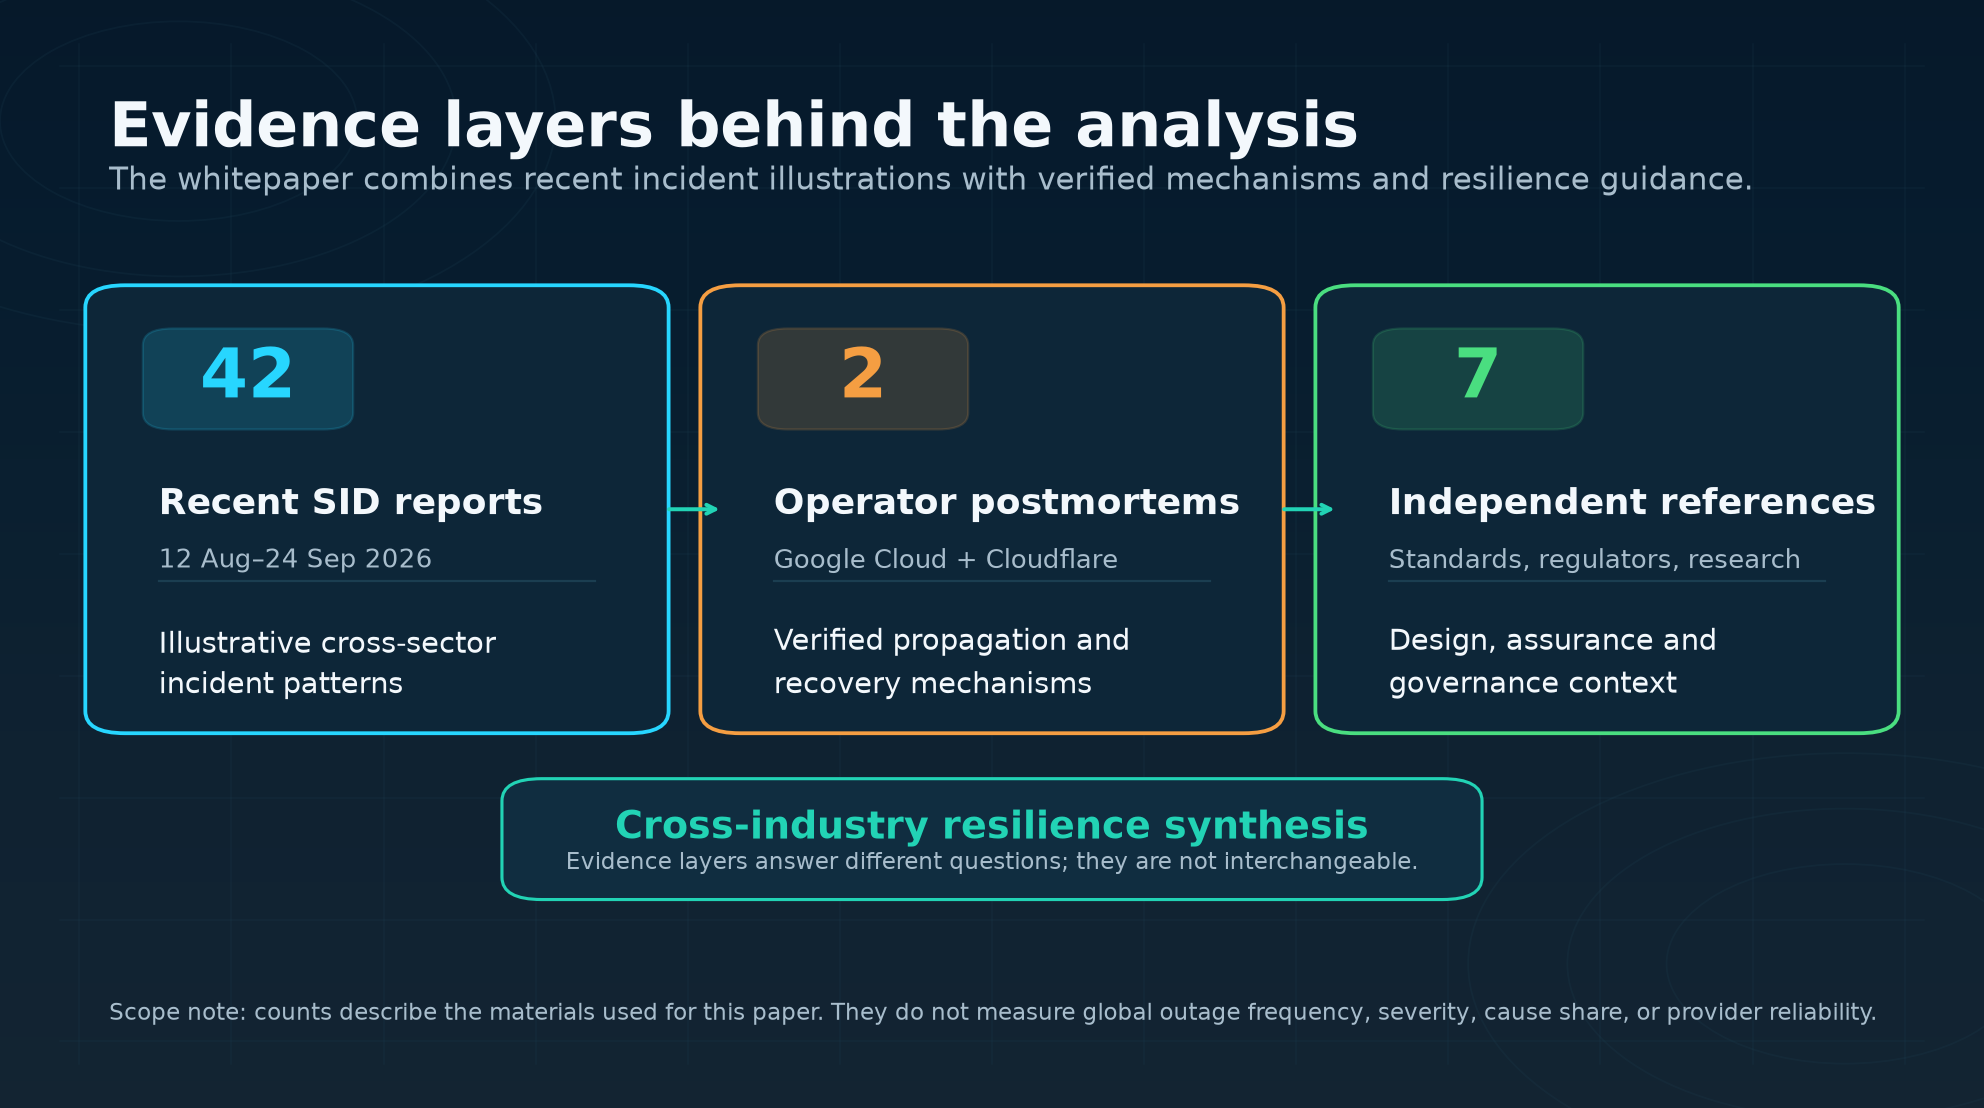
Dit whitepaper herzien een 42-post Status Is Down redacteurscorpus dat van 12 augustus tot en met 24 september 2026 is gepubliceerd, en vergelijkt vervolgens die illustraties met operator postmortems en regelgevende of standaardrichtlijnen. Het corpus is geen statistisch representatieve wereldwijde storingsdataset, dus het kan incidentfrequentie, vergelijkbare betrouwbaarheid of een dominante oorzaak niet vaststellen. Het kan echter terugkerende ontwerpvragen blootleggen over cloudplatforms, telecommunicatie, bankwezen, noodcommunicatie en transport.
De centrale bevinding is dat effectieve afhankelijkheidsconcentratie een smalle controle, milieu, routering, identiteit of verwerkingsfout kan omzetten in een multi-productincident. Gracieus verlies kan die blootstelling verminderen door een gedefinieerde, veilige en duidelijk gecommuniceerde minimumdienst te behouden. Veerkracht zou daarom moeten worden beoordeeld op kritieke uitkomsten en geverifieerde normalisatie—niet door een leveranciersaantal, een enkel beschikbaarheidspercentage of het moment waarop een upstream-provider "opgelost" plaatst.
Executieve samenvatting
De belangrijkste afhankelijkheid van een organisatie is niet altijd de meest zichtbare leverancier. Het kan een gedeeld authenticatiepad zijn, een configuratie-distributiesysteem, een kernprocessor, een datacenter koelinstallatie, een carrier-circuit, een statusplatform of een ondersteuningskanaal. Deze functies vormen een effectieve afhankelijkheidskern: een kleine set failure-domeinen die veel merkdiensten of klantreizen tegelijk kan onderbreken.
Gracieus verlies is het praktische tegenwicht. Het betekent opzettelijk een beperkte, veilige en begrijpelijke uitkomst behouden tijdens verslechtering. Het betekent niet stilzwijgend een inferieuze dienst accepteren, ervan uitgaande dat één alternatieve kanaal voor elke klant werkt, of succes verklaren terwijl rijen en afstemming werk zich opstapelen. De gedegradeerde modus heeft expliciete capaciteits-, integriteits- en klantcommunicatielimieten nodig, gevolgd door een geverifieerde terugkeer naar normale werking.
| Veerkrachtvraag | Bewijs dat leiders zouden moeten eisen |
|---|---|
| Waar is de afhankelijkheid geconcentreerd? | Een kaart van logische, fysieke, administratieve en derde-partij faalgebieden—niet alleen een leverancierslijst. |
| Wat blijft veilig bruikbaar? | Een getest minimum service voor elke belangrijke klant of openbare uitkomst, met aangegeven limieten en alternatieven. |
| Wanneer is het herstel voltooid? | Bewijs dat achterstanden, dataintegriteit, regionale service, ondersteuningskanalen en afhankelijke workflows genormaliseerd zijn. |
Waar concentratie zich verbergt
Logische concentratie kan net zo ingrijpend zijn als een beschadigde kabel of een defecte stroomvoorziening. In Status Is Down's Microsoft 365 en ChatGPT Work rapport, schreef Microsoft de voortdurende impact toe aan een probleem met de kern-authenticatieconfiguratie dat Exchange Online en verbonden samenwerking en beveiligingsdiensten bereikte. Het ChatGPT-evenement dat in hetzelfde artikel werd beschreven, was apart; nabijheid in tijd vestigde geen gemeenschappelijke oorzaak. Een later multi-provider AI rapport paste dezelfde waarborg toe: gelijktijdige productincidenten waren geen bewijs van één gedeelde cloudfout.
Twee eerste-partij postmortems tonen aan hoe propagatie een smalle wijziging kan versterken. Google Cloud meldde dat onbedoelde lege velden in quota-beleidsgegevens zich wereldwijd binnen enkele seconden replicateerden, een onvoldoende beveiligde Service Control codepad uitoefende en crashloops veroorzaakte. De meeste regio's begonnen te herstellen nadat de beleidsweg was uitgeschakeld, terwijl een herstartgroepseffect het herstel in een grote regio verlengde en sommige producten nog achterstanden hadden. Google meldde ook dat de gezondheid en sommige klantmonitoring infrastructuur verstoord waren.
Cloudflare traceerde zijn incident in november 2025 apart naar een wijziging in de database-permissies die een bestand voor de Bot Management-functie verdubbelde. Het te grote bestand verspreidde zich over het netwerk en overschreed een softwarelimiet. Cloudflare sloot expliciet een cyberaanval uit. De belangrijkste verkeersstroom was voor het grootste deel normaal tegen 14:30 UTC, maar alle systemen werden pas normaal gerapporteerd totdat 17:06 UTC. Deze mechanismen verklaren de incidenten van 2026 niet; ze demonstreren waarom configuratiegeneratie, validatie, implementatie, terugrollen en waarneembaarheid binnen het productie faalmodel behoren.
Fysieke en operationele concentratie kunnen ook een nominale back-up ondermijnen. In het telecommunicatie-incident van de Noordoostelijke luchthaven, viel een primaire communicatielijn uit terwijl een back-up vezelroute ook niet beschikbaar was nadat deze was doorgesneden. Herstel stelde de operaties in staat om te hervatten, maar de opgestapelde vluchtverstoring bleef. Een tweede lijn op een diagram is geen bewijs van veerkracht als deze een gangpad, faciliteit, controlevlak, stroombron of herstelbeperking met de eerste deelt.
Deels service is niet hetzelfde als beschikbaarheid
De financiële gevallen tonen aan waarom klantresultaten afzonderlijk moeten worden beoordeeld. Tijdens een UK-app-verstoringen, beschreef het Monzo rapport een onafhankelijke back-upbankregeling en bleef kaartbetalingen, geldopnames, kaartbevriezing en overschrijvingen mogelijk terwijl sommige app-functies beperkt waren. In het NAB-incident, werden digitale bankieren, handelen en telefonische contact beïnvloed, terwijl geldautomaten en snelle betalingen beschikbaar bleven en een Direct Entry-deadline werd verlengd. Geen van beide voorbeelden betekent dat elke klant een adequate vervanging had; het toont aan dat een organisatie continuïteit kan ontwerpen rondom specifieke taken in plaats van één front-end.
Gedeelde afhankelijkheden kunnen een ongelijkmatige impact produceren. Status Is Down’s Mastercard-processor overzicht documenteerde verschillende processor- en route-toestanden, zonder een universele betalingsfout of een eindtechnische oorzaak te claimen. Het Sharetec rapport beschreef instelling-specifieke verstoring nadat getroffen kredietverenigingen het incident toeschreven aan koeling- en failoverproblemen bij een gedeelde kern-dienstenleverancier. Kernherstel betekende niet automatisch dat saldi, digitaal bankieren en elke ledenworkflow tegelijkertijd werden vergeleken.
Die uitkomst-gedreven kader blijkt uit APRA’s CPS 230. Voor gereguleerde Australische instellingen vereist het tolerantiemarges voor maximale verstoring, dataverlies en minimumdienst onder alternatieve regelingen voor kritieke operaties. De FFIEC vraagt ook om analyse van enkele faalpunten en afhankelijkheden over kernverwerking, online en mobiel bankieren, afhandeling, nutsvoorzieningen en derde partijen. Dit zijn sector-specifieke vereisten en richtlijnen, geen universele juridische regels, maar het ontwerpbeginsel past goed: definieer de taak die moet doorgaan voordat je de back-up selecteert.
Noodcommunicatie en transport blootleggen pad-specifiek risico
Noodcommunicatie is niet één pad. Het Oklahoma 911 rapport onderscheidde vastelijnoproep voltooïng van draadloze routeringsproblemen en beschreef alternatieve tien-cijferige lijnen en overdrachten die tijdens de verstoring werden gebruikt. Het vestigde niet dat elk Oklahoma-callcenter gelijktijdig faalde, en geen van de beoordeelde bronnen leverde een totaal van mislukte oproepen of een meer specifieke oorzaak van de mislukking. Vergelijkbare zorg is nodig wanneer spraak, tekst, locatiegegevens, routering en lokale callcenter-aflevering verschillende staten hebben.
In de Verenigde Staten vereist de FCC dat covered providers 911-oproepen voltooien, locatie-informatie verzenden, circuitdiversiteit, back-upstroom en monitoring behandelen, en getroffen 911-faciliteiten van uitval op de hoogte stellen. Die regels zijn rechtsgebied-specifiek. Tijdens elke actieve verstoring van de nooddienst, moeten lezers de huidige instructies van de relevante lokale autoriteit volgen in plaats van een algemene monitoring- of nieuwspagina als vervanging te beschouwen.
Transportsystemen maken de herstelstaart zichtbaar. Herstelde communicaties kunnen een operationeel pad heropenen terwijl vliegtuigen, bemanningen en passagiers uit positie blijven. Gerenoveerde spoorinfrastructuur kan service mogelijk maken terwijl residuele vertragingen aanhouden. De les is niet dat elk transportincident een upstream oorzaak deelt; het is dat de status van het mogelijk makende actief en de status van de publieke uitkomst verschillende operationele feiten zijn.
Herstel is een volgorde, geen label
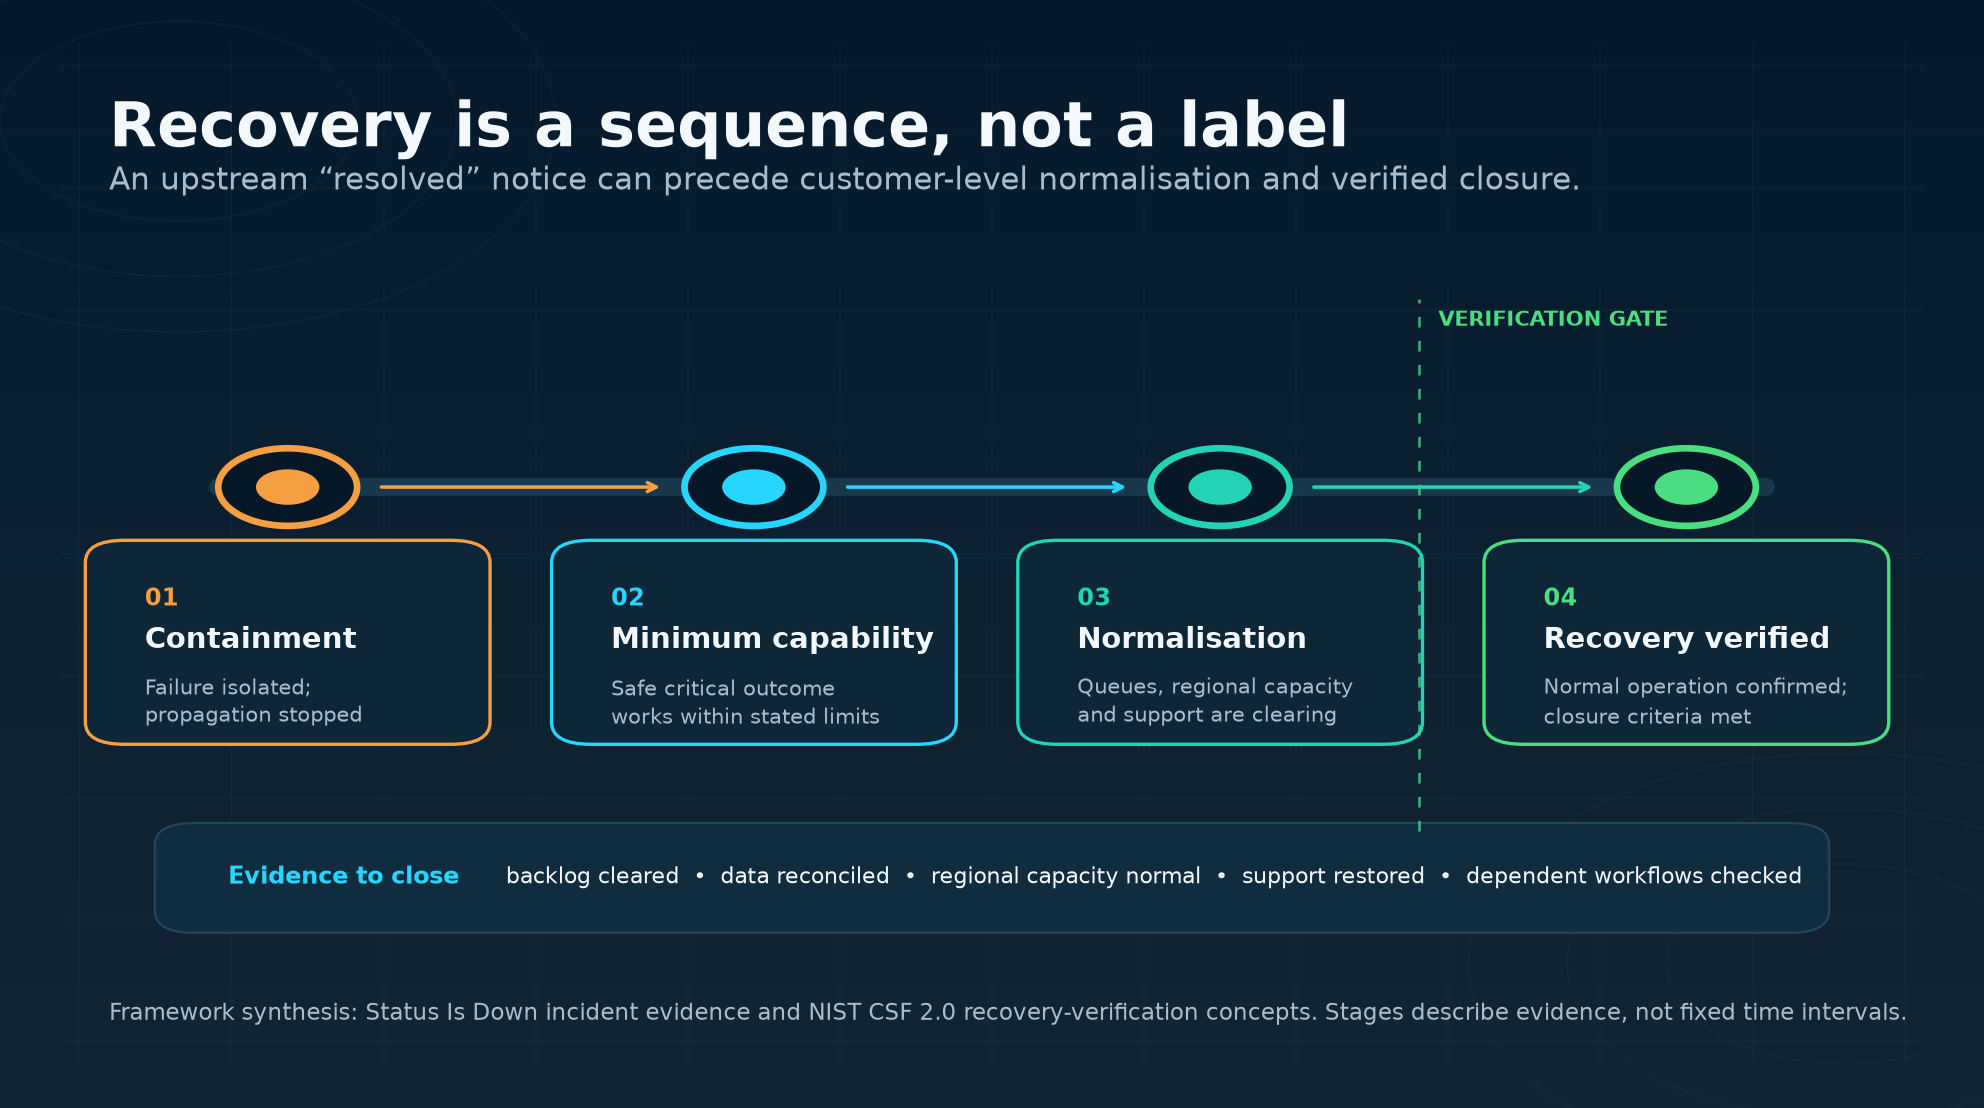
Precieze hersteltaal vermindert valse geruststelling en maakt verificatie eenvoudiger. Een praktisch vier-stappenmodel is:
- Containment: de storing is geïsoleerd of de propagatie is gestopt.
- Herstel van minimumcapaciteit: een gedefinieerde kritieke uitkomst of veilige alternatieve route is beschikbaar binnen de aangegeven limieten.
- Normalisatie in uitvoering: rijen, vertraagde taken, regionale capaciteit, klantenondersteuning, dataconsistentie en afhankelijke workflows worden vrijgemaakt of gecontroleerd.
- Herstel verklaard voltooid: integriteit en normale operationele status zijn geverifieerd tegen expliciete sluitingscriteria.
Dit onderscheid verschijnt in het incidentbewijs. J:COM meldde herstel van geliste diensten terwijl klantcentrum-calls moeilijk bleven. Het herstel van telecom op de luchthaven stelde operaties in staat om te hervatten voordat de schema's genormaliseerd waren. Google Cloud en Cloudflare registreerden beide een kloof tussen breed of kernherstel en het einde van residuele effecten.
Het NIST Cybersecurity Framework 2.0 formaliseert de verificatiestap voor cyberincidenten: herstelacties worden geselecteerd en geprioriteerd, herstelactiva worden gecontroleerd, herstelde activa-integriteit en normale operationele status worden bevestigd, en het einde van herstel wordt verklaard volgens criteria. Dezelfde discipline is nuttig buiten cybersecurity, zelfs waar het incident begint met stroom, koeling, telecommunicatie of een operationele fout.
Een vijfdelig programma voor gracieus verlies
Eerst, kaar het belangrijke resultaat en elk faalgebied dat het mogelijk maakt. Volg identiteit, DNS, edge-levering, controlevlakken, API's, processors, datacenters, carriers, monitoring en ondersteuning, inclusief vierde partijen en fysieke routes. Het EU DORA-kader behandelt kritische ICT derde-partij concentratie als een operationele veerkrachtvraag in de financiën; andere sectoren kunnen dezelfde analytische lens gebruiken zonder aan te nemen dat de regelgeving op hen van toepassing is.
Tweede, definieer de minimum levensvatbare modus. Geef aan welke klanttaken doorgaan, welke gegevens mogelijk worden vertraagd, wie prioriteit krijgt, welke capaciteitslimiet van toepassing is en hoe uitgestelde werkzaamheden zullen worden vergeleken. Een alternatief dat onveilig, ontoegankelijk of te klein is voor de vraag, is geen geloofwaardige gedegradeerde dienst.
Derde, engineer containment en failover. Afhankelijk van het systeem kunnen controlemaatregelen onder andere gelaagde uitrol, validatie, functie-vlaggen, kill-switches, gebonden herhalingen, gerandomiseerde exponentiële terugvallen, circuitonderbrekers, rijen, caches, sessiebeleid en handmatige oplossingen omvatten. Google’s postmortem identificeerde verschillende van deze als herstelgebieden; de exacte controle-set moet passen bij de dienst en zijn risico.
Vierde, behoud onafhankelijke waarneembaarheid en communicatie. De statuspagina, monitoringstack en ondersteuningskanaal kunnen dezelfde afhankelijkheid delen als productie. Organisaties moeten een aparte manier identificeren om klantresultaten waar te nemen en goedgekeurde updates publiceren die symptomen, bevestigde reikwijdte, oorzaakstatus, oplossingen, capaciteitsherstel, normalisatie en sluiting onderscheiden.
Vijfde, oefen de gecombineerde storing. De FCA's operationele veerkracht richtlijnen vraagt bedrijven in scope om mensen, processen, technologie, faciliteiten, informatie en derde partijen in kaart te brengen, en vervolgens ernstige maar plausibele scenario's te testen. Het maakt ook onderscheid tussen herstel-tijddoeleinden en impacttoleranties en merkt op dat responsacties tijd kunnen kopen terwijl het herstel voltooid is. Een nuttige oefening moet daarom gezamenlijk afhankelijkheidsverlies, gedeeltelijke service, niet-beschikbare normale communicaties, ondersteuningsoverbelasting en het vrijmaken van achterstanden testen—niet alleen of een back-upserver start.
Maatregelen die besturen kunnen gebruiken
Een enkel beschikbaarheidspercentage kan niet tonen of een klant een betaling heeft voltooid, nooddiensten heeft bereikt, heeft ingecheckt voor een vlucht of toegang heeft gekregen tot een cruciale accountfunctie. Resultaat-gedreven maatregelen kunnen onder andere tijd tot detectie, tijd tot de eerste bruikbare noodoplossing, het percentage of volume van kritieke taken die veilig zijn voltooid, rijleeftijd, reconciliatie-uitzonderingen, beschikbaarheid van ondersteuningskanalen, tijd tot geverifieerde normale operaties en onopgeloste herstelrisico's omvatten.
Uptime Institute's 2026 analyse biedt bredere context: het rapporteert dat de uitvalfrequentie per site voor het vijfde jaar op rij is gedaald, terwijl externe infrastructuurstoringen prominenter werden in openbaar gerapporteerde uitvallen en vezel- en connectiviteitsincidenten waarschijnlijker waren om uitgebreide verstoring te produceren. Het bewijs combineert enquêtes, openbare rapporten, leden, partners en zijn eigen database. Deze bevindingen moeten niet worden behandeld als een census van het Status Is Down corpus, maar ze benadrukken de noodzaak om verder te kijken dan interne apparatuur en externe afhankelijkheden in kaart te brengen.
Wat dit betekent voor gebruikers van Status Is Down
Status Is Down kan dat werk ondersteunen door teams te helpen huidige gebruikerssignalen te vergelijken met operatorupdates over zijn website-registraties, dienstdirectory en real-time dashboard. Deze bronnen aanvullen, in plaats van vervangen, officiële provider-, nood- of transportinstructies.
Een account aanmaken en een monitoringsplan selecteren, kan teams helpen de externe diensten waarvan ze afhankelijk zijn te volgen en context toe te voegen aan hun eigen telemetrie. De grotere veerkrachttaak blijft organisatorisch: definieer de kritieke uitkomst, test de gedegradeerde modus en verifieer het pad terug naar normaal. Lezers kunnen ook aanvullende onderzoeken verkennen in de Industriewhitepapers collectie.
Methodologie en beperkingen
Het Status Is Down materiaal dat hier is gebruikt, is een redactioneel geselecteerd, bron-gelinkt corpus, geen prevalentiestudie. Artikelentellingen kunnen geen claims over frequentie, ernst, geografie, duur, vergelijkbare betrouwbaarheid of oorzaakdeel ondersteunen. Tijdelijke rapporten kunnen ook worden herzien door latere operatoranalyse. De oorzaaktaal blijft daarom smal: bevestigd waar een postmortem bestaat, toegeschreven waar een operator of instelling een verslag heeft geleverd, en onvermeld waar het bewijs niet meer vaststelde.
Gelijktijdigheid is geen causaliteit. Vergelijkbare symptomen of overlappende timing bewijzen geen gedeelde cloud, carrier, cyberaanval, sabotage-evenement of leveranciersfailure. Gedeeltelijke beschikbaarheid is ook geen bewijs van onschadelijkheid: een geldautomaat, kaartroute, alternatief nummer of tekstkanaal kunnen geschiktheid, capaciteit, toegankelijkheid of geografische limieten hebben. Tenslotte beschrijven de regelgevende bronnen in dit document hun eigen sectoren en jurisdicties en moeten ze niet worden gelezen als juridisch advies.
Conclusie
Een veerkrachtige dienst belooft niet dat elk onderdeel voor altijd beschikbaar blijft. Het maakt afhankelijkheidsgrenzen zichtbaar, beperkt de explosieradius, behoudt gedefinieerde kritieke uitkomsten waar veilig, communiceert wat gebruikers wel en niet kunnen doen, en verklaart herstel pas compleet na verificatie. Voor leiders die recente uitvaltrends beoordelen, is gracieus verlies niet een zachtere versie van uptime; het is de operationele discipline die geconcentreerde afhankelijkheden verandert in begrensd, meetbaar risico.
Bronnen
- Status Is Down: Microsoft 365 storing laat een klein aantal getroffen gedurende de derde dag; ChatGPT Work herstelt na vijf uur verstoring
- Status Is Down: ChatGPT en Claude uitval raakt AI-gebruikers terwijl rapporten zich verspreiden via Gemini, Copilot en Grok
- Status Is Down: Cuba begint netwerkherstel na landelijke blackout; Sharetec storing verstoort kredietverenigingen
- Status Is Down: J:COM herstelt breedband na wijdverspreide Japan verstoring; NAB lost digitale bank-uitval op
- Status Is Down: Noordoostelijke luchthaven operaties hervatten na telecom uitval; Michigan State nutsvoorziening herstel gaat door
- Status Is Down: Mastercard betalingen falen wereldwijd: vijf processors rapporteren fouten voor herstel begint
- Status Is Down: Monzo activeert back-upbank te midden van UK app-uitval; IndiGo reserveringsfout blokkeert boekingen in India
- Status Is Down: Oklahoma herstelt 911 routering na netwerkprobleem; omgevallen palen verstoren Long Island spoorverkeer
- Google Cloud: Meerdere GCP-producten ervaren serviceproblemen
- Cloudflare: Cloudflare storing op 18 november 2025
- Uptime Institute: Jaarlijks Uitval Analyse Rapport 2026
- National Institute of Standards and Technology: Het NIST Cybersecurity Framework (CSF) 2.0
- Financial Conduct Authority: Operationele veerkracht: inzichten en observaties voor bedrijven
- Federal Communications Commission: 911 Betrouwbaarheid
- Australian Prudential Regulation Authority: Prudential Standard CPS 230 Operationele Risico Management
- European Insurance and Occupational Pensions Authority: Digital Operational Resilience Act (DORA)
- Federal Financial Institutions Examination Council: Business Continuity Management: Interdependency Analyse
Afbeeldingscredit: Illustratie gegenereerd voor Status Is Down