Wenn ‚Down‘ nicht ‚Gone‘ ist: Entwurf einer sanften Degradation für konzentrierte digitale Abhängigkeiten
Die meisten Ausfallberichte beginnen mit einer binären Frage: Ist der Dienst aktiv oder down? Jüngste Vorfälle über Branchen hinweg weisen auf eine nützlichere Frage für Technologie-, Risiko- und Betriebsleiter hin: Welche Kundenergebnisse funktionieren noch, wenn eine gemeinsame Abhängigkeit ausfällt, und wie wird die Organisation wissen, wann die Wiederherstellung tatsächlich abgeschlossen ist?
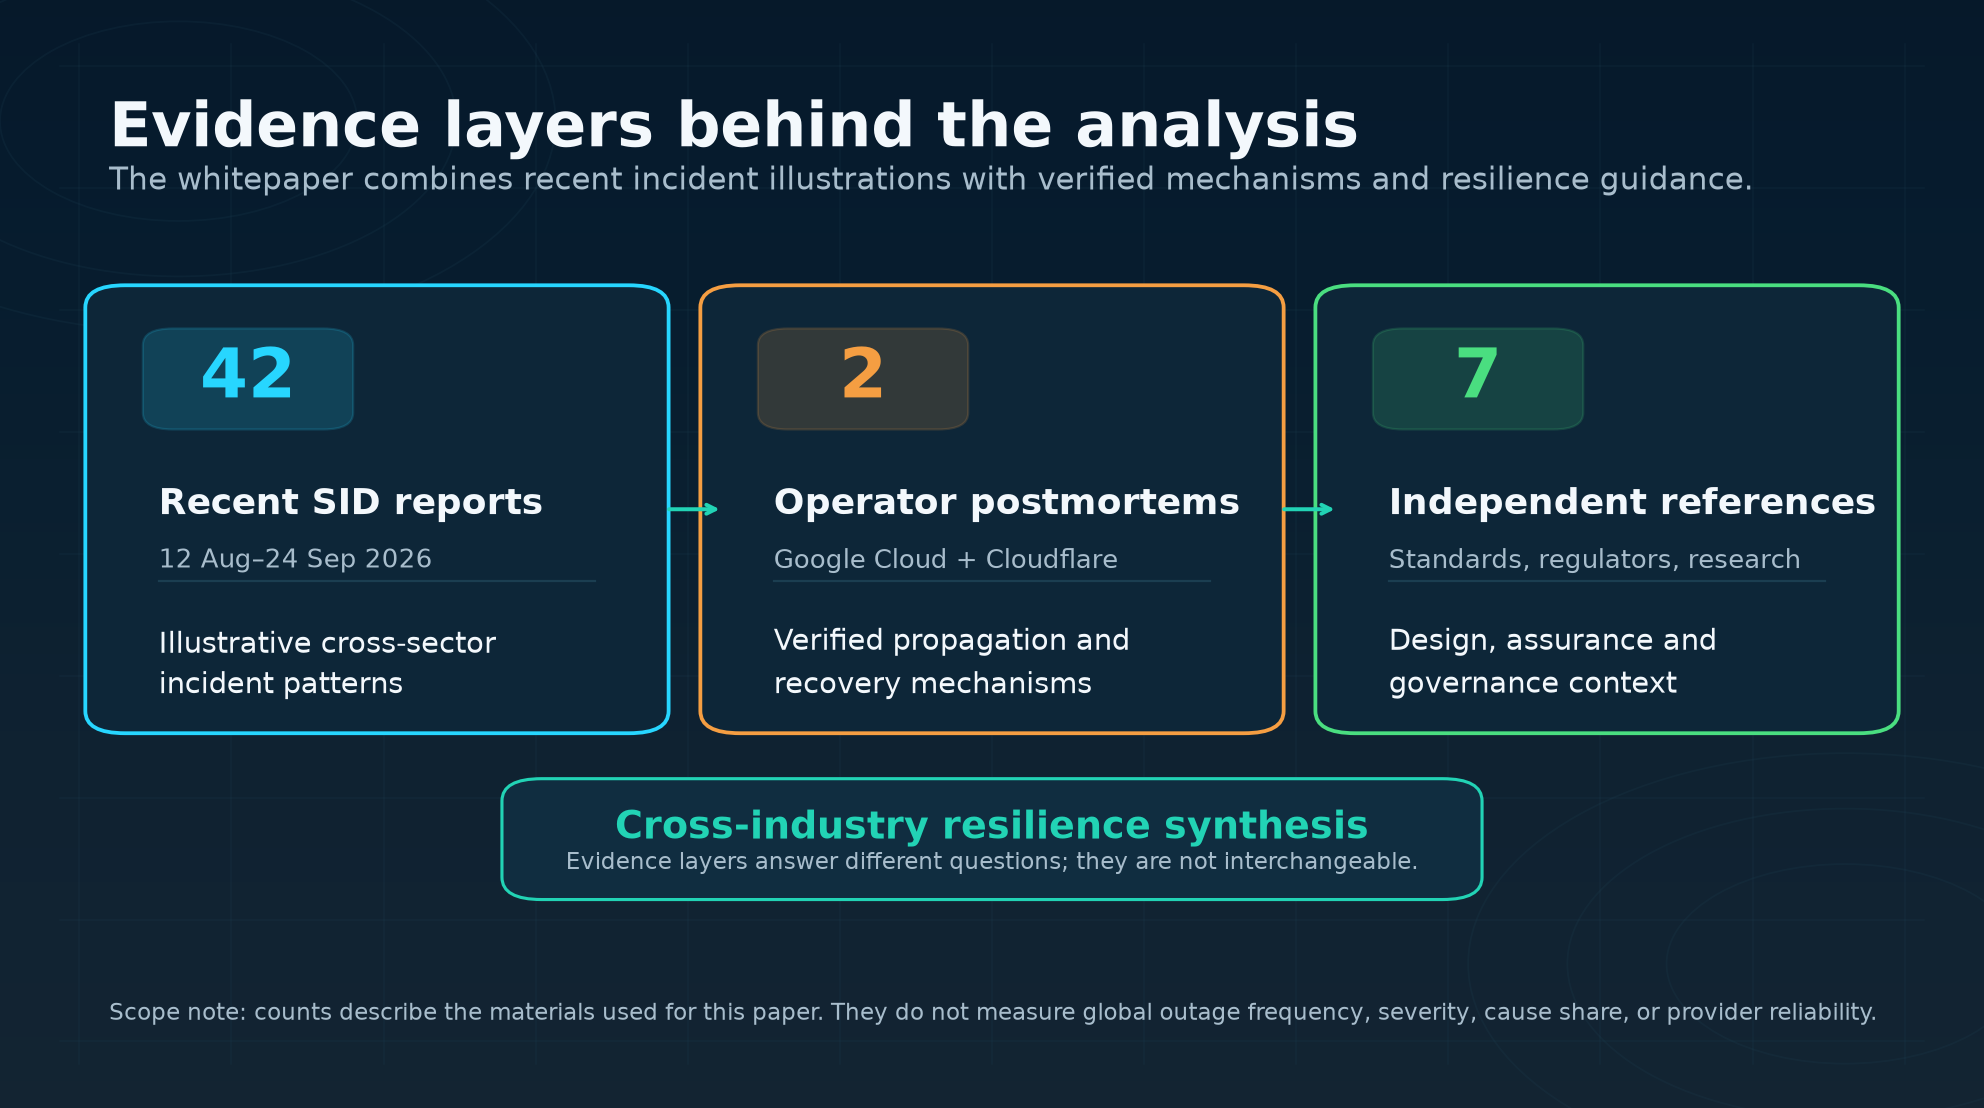
Dieses Whitepaper überprüft einen redaktionellen Korpus von 42 Beiträgen von Status Is Down, die vom 12. August bis 24. September 2026 veröffentlicht wurden, und vergleicht diese Illustrationen mit Nachberichten von Betreibern und regulatorischen oder standardbezogenen Leitlinien. Der Korpus ist kein statistisch repräsentatives globales Ausfalldataset, daher kann er keine Häufigkeit von Vorfällen, vergleichbare Zuverlässigkeit oder eine dominante Ursache feststellen. Er kann jedoch wiederkehrende Entwurfsfragen über Cloud-Plattformen, Telekommunikation, Banken, Notfallkommunikation und Transport aufdecken.
Das zentrale Ergebnis ist, dass eine effektive Konzentration von Abhängigkeiten eine enge Kontroll-, Umwelt-, Routing-, Identitäts- oder Verarbeitungsfehlfunktion in einen multi-Produkt-Vorfall verwandeln kann. Sanfte Degradation kann diese Exposition verringern, indem ein definiertes, sicheres und klar kommuniziertes Minimum an Dienstleistung bewahrt wird. Resilienz sollte daher an kritischen Ergebnissen und verifizierter Normalisierung gemessen werden – nicht an der Anzahl der Anbieter, einem einzigen Verfügbarkeitsprozentsatz oder dem Moment, in dem ein upstream Anbieter „gelöst“ meldet.
Zusammenfassung
Die wichtigste Abhängigkeit einer Organisation ist nicht immer ihr sichtbarster Anbieter. Es kann ein gemeinsamer Authentifizierungsweg, ein Konfigurationsverteilungssystem, ein zentraler Prozessor, ein Kühlwerk eines Rechenzentrums, ein Übertragungskreislauf, eine Statusplattform oder ein Unterstützungs Kanal sein. Diese Funktionen bilden einen effektiven Abhängigkeitskern: eine kleine Menge von Fehlbereichen, die viele markenbezogene Dienste oder Kundenreisen gleichzeitig unterbrechen können.
Sanfte Degradation ist das praktische Gegengewicht. Es bedeutet, absichtlich ein begrenztes, sicheres und verständliches Ergebnis während einer Beeinträchtigung zu bewahren. Es bedeutet nicht, stillschweigend einen minderwertigen Dienst zu akzeptieren, anzunehmen, dass ein alternativer Kanal für jeden Kunden funktioniert, oder Erfolg zu erklären, während sich Warteschlangen und Abrechnungsarbeiten sammeln. Der degradierte Modus benötigt explizite Kapazität, Integrität und Kommunikationsgrenzen mit Kunden, gefolgt von einer verifizierten Rückkehr zum normalen Betrieb.
| Resilienzfrage | Beweise, die Führer verlangen sollten |
|---|---|
| Wo ist die Abhängigkeit konzentriert? | Eine Karte logischer, physischer, administrativer und dritter Fehlbereiche – nicht nur eine Anbieter-Liste. |
| Was bleibt sicher verfügbar? | Ein getesteter Mindestdienst für jedes wichtige Kunden- oder öffentliche Ergebnis, mit festgelegten Grenzen und Alternativen. |
| Wann ist die Wiederherstellung abgeschlossen? | Beweise, dass Rückstände, Datenintegrität, regionaler Dienst, Unterstützungs-kanäle und abhängige Arbeitsabläufe normalisiert sind. |
Wo Konzentration versteckt ist
Logische Konzentration kann ebenso folgenschwer sein wie ein beschädigtes Kabel oder eine ausgefallene Stromversorgung. Im Microsoft 365 und ChatGPT Arbeitsbericht von Status Is Down führte Microsoft die anhaltenden Auswirkungen auf ein zentrales Authentifizierungskonfigurationsproblem zurück, das Exchange Online und verbundene Kollaborations- und Sicherheitsdienste erreichte. Das im selben Artikel beschriebene ChatGPT-Ereignis war davon getrennt; Nähe in der Zeit stellte keine gemeinsame Ursache her. Ein späterer Bericht über mehrere Anbieter von KI wandte dieselbe Sicherheitsvorkehrung an: gleichzeitige Produktvorfälle waren kein Beweis für einen gemeinsamen Cloud-Ausfall.
Zwei Nachberichte von ersten Anbietern zeigen, wie sich die Ausbreitung verstärken kann. Google Cloud berichtete, dass unbeabsichtigt leere Felder in den Daten der Quotapolitik innerhalb von Sekunden global repliziert wurden, einen unzureichend geschützten Service-Control-Code-Pfad nutzten und Absturzschleifen verursachten. Die meisten Regionen begannen, sich zu erholen, nachdem der Politikpfad deaktiviert wurde, während ein Restart-Herdeffekt die Wiederherstellung in einer großen Region verlängerete und einige Produkte residuale Rückstände aufwiesen. Google bemerkte auch, dass die Gesundheits- und einige Kundenüberwachungsinfrastrukturen beeinträchtigt waren.
Cloudflare hat seine Vorfälle im November 2025 separat auf eine Änderung der Datenbankberechtigungen zurückgeführt, die die Datei einer Bot-Verwaltungsfunktion verdoppelt hat. Die übergroße Datei verbreitete sich über das Netzwerk und überschritt ein Softwarelimit. Cloudflare schloss ausdrücklich einen Cyberangriff aus. Der Kernverkehr war ab 14:30 UTC größtenteils normal, aber es wurde nicht berichtet, dass alle Systeme bis 17:06 UTC normal waren. Diese Mechanismen erklären die Vorfälle von 2026 nicht; sie zeigen, warum die Konfigurationserzeugung, Validierung, Bereitstellung, Rückgängigmachung und Sichtbarkeit innerhalb des Produktionsfehlermodells gehören.
Physische und operationale Konzentration kann auch ein nominales Backup besiegen. Im Vorfall der Telekommunikation am Flughafen im Nordosten fiel ein primärer Kommunikationskreis aus, während eine Backup-Faserroute ebenfalls nicht verfügbar war, nachdem sie abgeschnitten wurde. Reparaturen ermöglichten die Wiederaufnahme des Betriebs, aber angesammelte Flugunterbrechungen blieben. Eine zweite Linie in einem Diagramm ist kein Beweis für Resilienz, wenn sie einen Korridor, eine Einrichtung, einen Steuerungsbereich, eine Stromquelle oder eine Einschränkung bei der Reparatur mit der ersten teilt.
Teildienst ist nicht dasselbe wie Verfügbarkeit
Die Finanzfälle zeigen, warum Kundenergebnisse separat bewertet werden sollten. Während einer Beeinträchtigung der App im Vereinigten Königreich beschrieb der Monzo Bericht eine unabhängige Backup-Bank-Anordnung und weiterhin Kartenzahlungen, Bargeldabhebungen, Kartensperrungen und Überweisungen, während einige App-Funktionen eingeschränkt waren. Im NAB-Vorfall waren digitales Banking, Handel und telefonischer Kontakt betroffen, während Geldautomaten und Schnellzahlungen verfügbar blieben und eine Frist für die Direct Entry verlängert wurde. Keines der Beispiele bedeutet, dass jeder Kunde einen angemessenen Ersatz hatte; es zeigt, dass eine Organisation Kontinuität um spezifische Aufgaben herum gestalten kann, anstatt um eine Oberfläche.
Gemeinsame Abhängigkeiten können ungleichmäßige Auswirkungen hervorrufen. Status Is Down’s Zusammenstellung von Mastercard-Zahlungsanbietern dokumentierte verschiedene Status von Verarbeitungs- und Routenwechseln, ohne einen universellen Zahlungsfehler oder eine endgültige technische Ursache zu beanspruchen. Der Sharetec Bericht beschrieb institutionsspezifische Unterbrechungen, nachdem betroffene Kreditgenossenschaften den Vorfall auf Kühl- und Failoverprobleme bei einem gemeinsamen Dienstanbieter zurückführten. Die Wiederherstellung des Kerns bedeutete nicht automatisch, dass Guthaben, digitales Banking und jeder Mitgliederworkflow zur gleichen Zeit abgeglichen waren.
Dieses ergebnisorientierte Framing spiegelt sich in APRA’s CPS 230 wider. Für regulierte australische Institutionen verlangt es Toleranzen für maximale Unterbrechungen, Datenverluste und Mindestdienste unter alternativen Vorkehrungen für kritische Operationen. Das FFIEC verlangt ebenfalls eine Analyse einzelner Fehlerpunkte und Abhängigkeiten über Kernverarbeitung, Online- und Mobile Banking, Abwicklung, Versorgungsunternehmen und Dritte. Dies sind sektorspezifische Anforderungen und Leitlinien, keine universellen gesetzlichen Regeln, aber das Designprinzip trägt gut mit: Definieren Sie die Aufgabe, die fortgesetzt werden muss, bevor Sie das Backup auswählen.
Notfallkommunikation und Transport legen wegspezifisches Risiko offen
Notfallkommunikation ist kein einziger Weg. Der Oklahoma 911 Bericht unterschied zwischen der Fertigstellung von leitungsgebundenen Anrufen und Problemen mit drahtlosen Routen und beschrieb alternative zehnstellige Linien und Transfers, die während der Unterbrechung verwendet wurden. Er stellte nicht fest, dass jedes Oklahoma-Callcenter gleichzeitig ausfiel, und keine überprüfte Quelle lieferte eine Gesamtzahl der fehlgeschlagenen Anrufe oder eine spezifischere Grundursache. Ähnliche Sorgfalt ist geboten, wenn Sprach-, Text-, Standortdaten, Routing und lokale Callcenter-Zustellung unterschiedliche Zustände haben.
In den Vereinigten Staaten verlangt die FCC, dass beteiligte Anbieter 911-Anrufe beenden, Standortinformationen übertragen, Schaltkreisvielfalt, Backup-Strom und Überwachung behandeln und betroffene 911-Einrichtungen über Ausfälle informieren, die sie beeinträchtigen könnten. Diese Regeln sind gerichtsspezifisch. Während einer aktiven Unterbrechung des Notdienstes sollten Leser die aktuellen Anweisungen der jeweiligen lokalen Behörde befolgen, anstatt eine allgemeine Überwachungs- oder Nachrichten-Seite als Ersatz zu betrachten.
Transportsysteme machen den Wiederherstellungsrückstand sichtbar. Wiederhergestellte Kommunikation kann einen Betriebspfad wiedereröffnen, während Flugzeuge, Besatzungen und Passagiere weiterhin falsch positioniert sind. Reparierte Schieneninfrastrukturen können den Dienst erlauben, während restliche Verspätungen bestehen bleiben. Die Lektion ist nicht, dass jeder Transportvorfall eine upstream-Ursache teilt; es ist, dass der Status des aktivierenden Vermögenswerts und der Status des öffentlichen Ergebnisses unterschiedliche operationale Fakten sind.
Wiederherstellung ist eine Abfolge, kein Label
Präzise Sprache zur Wiederherstellung reduziert falsche Sicherheit und erleichtert die Überprüfung. Ein praktisches Modell mit vier Phasen ist:
- Containment: Der Fehler ist isoliert oder seine Ausbreitung ist gestoppt.
- Minimale Fähigkeit wiederhergestellt: Ein definiertes kritisches Ergebnis oder ein sicherer alternativer Weg ist innerhalb seiner festgelegten Grenzen verfügbar.
- Normalisierung im Gange: Warteschlangen, verzögerte Aufträge, regionale Kapazität, Kundenunterstützung, Datenkonsistenz und abhängige Arbeitsabläufe werden bereinigt oder überprüft.
- Wiederherstellung erklärt als abgeschlossen: Integrität und normaler Betriebsstatus wurden gegen explizite Kriterien verifiziert.
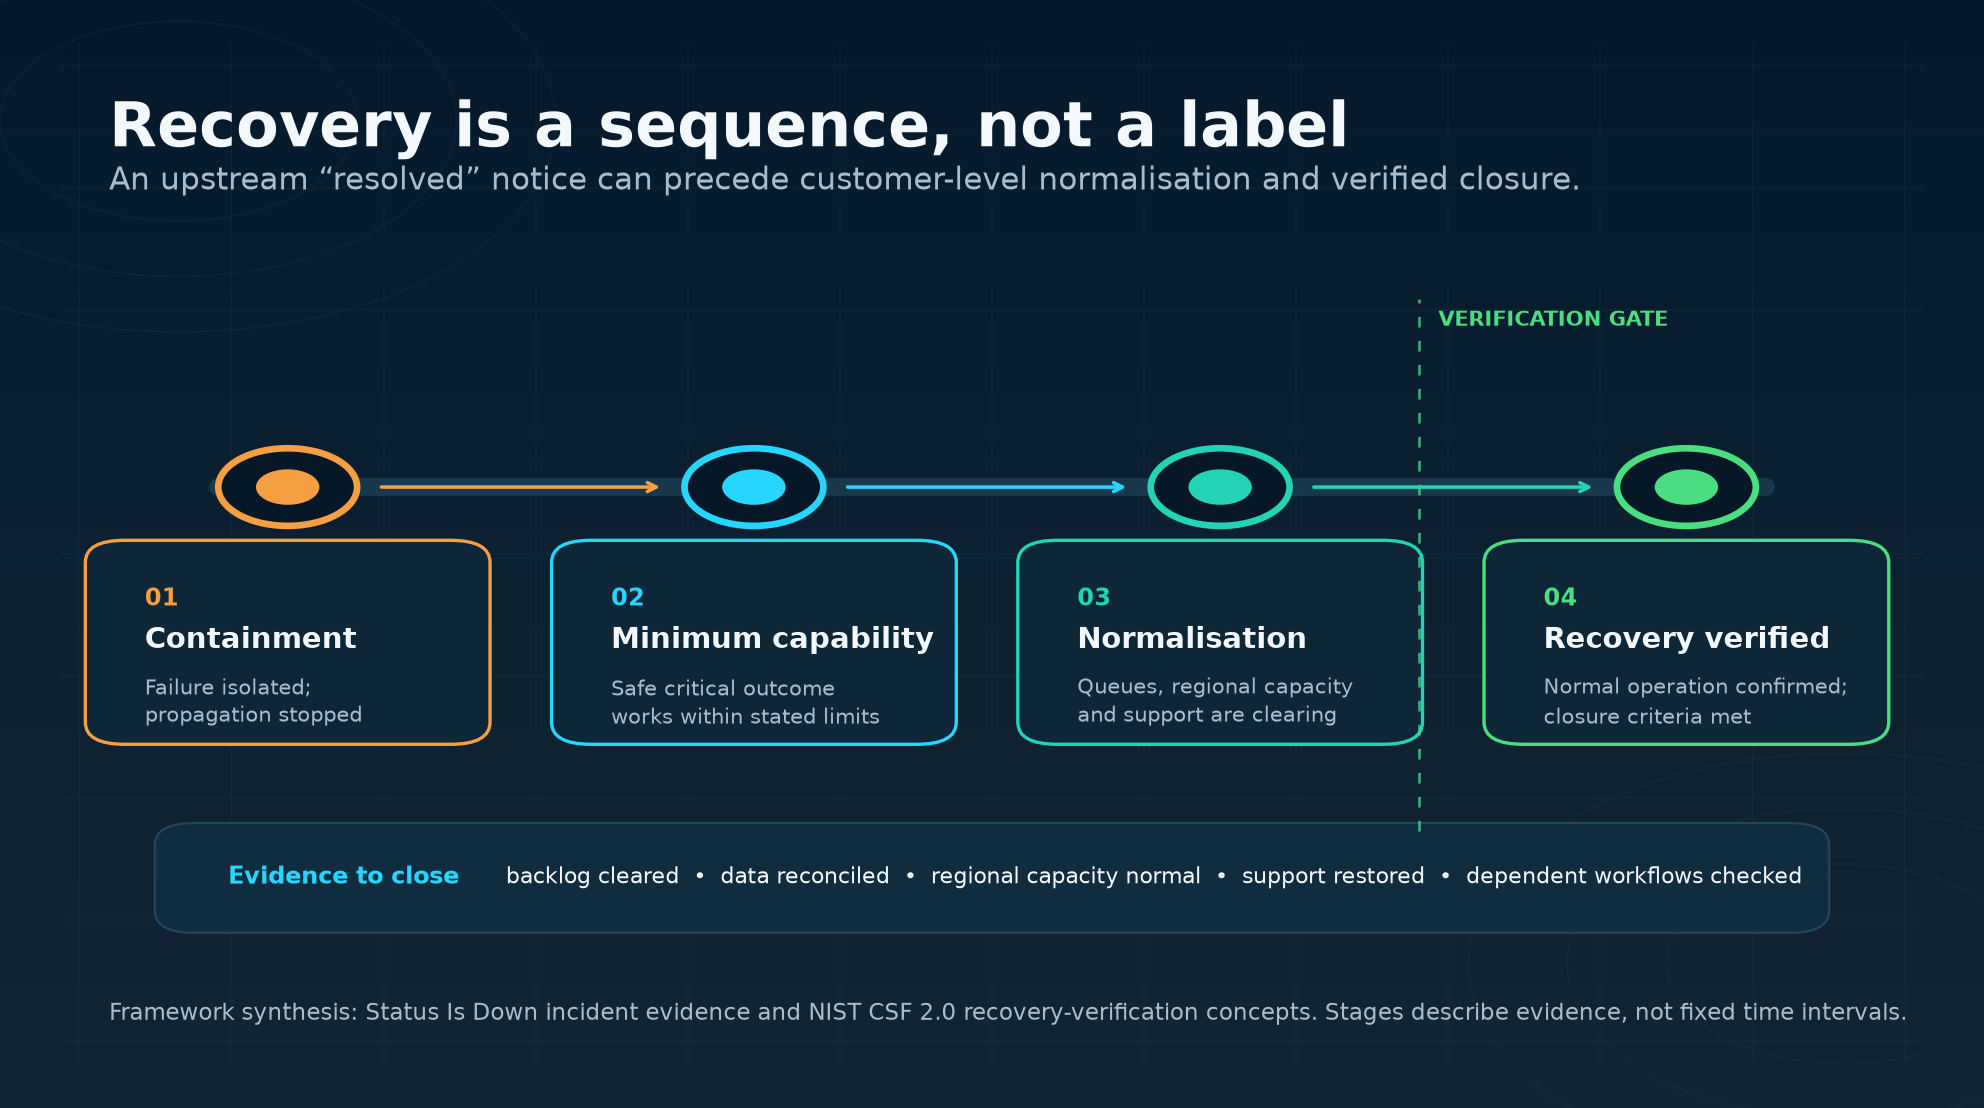
Diese Unterscheidung zeigt sich in den Vorfallsbeweisen. J:COM berichtete über die Wiederherstellung aufgelisteter Dienste, während Anrufe im Kundenservice weiterhin schwierig blieben. Die Reparatur der Telekommunikation am Flughafen ermöglichte die Wiederaufnahme des Betriebs, bevor die Fahrpläne normalisiert wurden. Google Cloud und Cloudflare verzeichneten beide eine Diskrepanz zwischen breiter oder grundlegender Wiederherstellung und dem Ende der residualen Auswirkungen.
Das NIST Cybersecurity Framework 2.0 formalisiert den Verifizierungsschritt für Cybervorfälle: Wiederherstellungsmaßnahmen werden ausgewählt und priorisiert, Wiederherstellungsressourcen werden überprüft, die Integrität wiederhergestellter Vermögenswerte und der normale Betriebsstatus werden bestätigt, und das Ende der Wiederherstellung wird gegen Kriterien erklärt. Die gleiche Disziplin ist auch außerhalb der Cybersicherheit nützlich, selbst wenn der Vorfall mit Strom, Kühlung, Telekommunikation oder einem Betriebsfehler beginnt.
Ein fünfteiliger Plan für sanfte Degradation
Erstens: Kartierung des wichtigen Ergebnisses und jedes Fehlbereichs, der es ermöglicht. Verfolgen Sie Identität, DNS, Edge-Bereitstellung, Steuerungsbereiche, APIs, Prozessoren, Rechenzentren, Anbieter, Überwachung und Unterstützung, einschließlich vierter Parteien und physischer Routen. Der DORA-Rahmen des EU behandelt die Konzentration kritischer IKT-Drittanbieter als ein Anliegen für betriebliche Resilienz im Finanzwesen; andere Sektoren können denselben analytischen Ansatz verwenden, ohne anzunehmen, dass die Regulierung für sie gilt.
Zweitens: Definieren Sie den minimalen tragfähigen Modus. Geben Sie an, welche Kundentasks fortgesetzt werden, welche Daten möglicherweise verzögert werden, wer Priorität erhält, welches Kapazitätslimit gilt und wie aufgeschobene Arbeiten abgeglichen werden. Ein unsicherer, unzugänglicher oder zu kleiner alternativer Weg ist kein glaubwürdiger degradierter Dienst.
Drittens: Eindämmung und Failover konstruieren. Abhängig vom System können Kontrollen ein gestuftes Rollout, Validierung, Feature-Flags, Kill-Switches, begrenzte Wiederholungen, randomisierte exponentielle Rückstöße, Leistungsschutzschalter, Warteschlangen, Caches, Sitzungspolitik und manuelle Umgehungen umfassen. Der Nachbericht von Google identifizierte mehrere dieser Maßnahmen als Bereiche für die Behebung; die genaue Kontrolle muss zu dem Dienst und seinem Risiko passen.
Viertens: Bewahren Sie unabhängige Sichtbarkeit und Kommunikation. Die Statusseite, der Überwachungsstack und der Unterstützungs Kanal können die gleiche Abhängigkeit wie die Produktion teilen. Organisationen sollten einen separaten Weg identifizieren, um die Ergebnisse der Kunden zu beobachten und genehmigte Updates zu veröffentlichen, die Symptome, bestätigten Umfang, Ursachenstatus, Umgehungen, Wiederherstellungsfähigkeiten, Normalisierung und Abschluss unterscheiden.
Fünftens: Üben Sie den kombinierten Fehler. Die Richtlinien zur operationellen Resilienz der FCA verlangen von Unternehmen innerhalb des Geltungsbereichs, Personen, Prozesse, Technologie, Einrichtungen, Informationen und Dritte zu kartieren und dann schwere, aber plausible Szenarien zu testen. Es unterscheidet auch zwischen Wiederherstellungszeit-Objektiven und Auswirkungstoleranzen und stellt fest, dass Reaktionsmaßnahmen Zeit kaufen können, während die Wiederherstellung abgeschlossen ist. Eine nützliche Übung sollte daher den Verlust von Abhängigkeiten, Teildienste, nicht verfügbare normale Kommunikationen, Unterstützung überlastet und das Abräumen von Rückständen gemeinsam testen – nicht nur, ob ein Backup-Server gestartet ist.
Maßnahmen, die Vorstände nutzen können
Ein einzelner Verfügbarkeitsprozentsatz kann nicht zeigen, ob ein Kunde eine Zahlung abgeschlossen, Notdienste erreicht, sich für einen Flug eingecheckt oder auf eine kritische Kontofunktion zugegriffen hat. Ergebnisorientierte Maßnahmen können die Zeit bis zur Erkennung, die Zeit bis zum ersten nutzbaren Notfall, den Prozentsatz oder das Volumen der erfolgreich abgeschlossenen kritischen Aufgaben, das Alter der Warteschlange, Abgleichausnahmen, Verfügbarkeit des Unterstützungs Kanals, Zeit bis zur verifizierten Normalität und ungelöste Wiederherstellungsrisiken umfassen.
Die Analyse des Uptime Institute 2026 bietet einen breiteren Kontext: Sie berichtet, dass die Ausfallhäufigkeit pro Standort im fünften Jahr zurückgegangen ist, während externe Infrastrukturfehler in öffentlich gemeldeten Ausfällen prominenter wurden und Glasfaser- und Konnektivitätsvorfälle wahrscheinlicher zu verlängerten Unterbrechungen führten. Ihre Beweise kombinieren Umfragen, öffentliche Berichte, Mitglieder, Partner und die eigene Datenbank. Diese Ergebnisse sollten nicht als Zensus des Status Is Down Korpus betrachtet werden, betonen jedoch die Notwendigkeit, über interne Ausstattungen hinauszuschauen und externe Abhängigkeiten zu kartieren.
Was das für Status Is Down-Nutzer bedeutet
Status Is Down kann diese Arbeit unterstützen, indem es Teams hilft, aktuelle Nutzersignale mit Betreiber-Updates über seine Websiterekorde, Serviceverzeichnis und Echtzeit-Dashboard zu vergleichen. Diese Ressourcen ergänzen, ersetzen jedoch nicht die offiziellen Anbieter-Notfall- oder Verkehrs-anweisungen.
Ein Konto zu erstellen und einen Überwachungsplan auszuwählen, kann Teams helfen, die externen Dienste, von denen sie abhängen, zu verfolgen und den Kontext ihrer eigenen Telemetrie hinzuzufügen. Die größere Resilienzaufgabe bleibt organisatorisch: Definieren Sie das kritische Ergebnis, testen Sie den degradierenden Modus und verifizieren Sie den Weg zurück zur Normalität. Leser können auch weitere Forschung in der Sammlung von Branchen-Whitepapers erkunden.
Methodologie und Limits
Das hier verwendete Material von Status Is Down ist ein redaktionell ausgewählter, quellenverlinkter Korpus, kein Prävalenzstudie. Artikelzählungen können keine Behauptungen über Häufigkeit, Schwere, Geographie, Dauer, vergleichbare Zuverlässigkeit oder Anteil der Grundursache unterstützen. Zeitgenössische Berichte können ebenfalls durch späteren Betreibersanalysen überarbeitet werden. Die Sprache der Ursachen bleibt daher eng: bestätigt, wo ein Nachbericht existiert, zugeschrieben, wo ein Betreiber oder eine Institution einen Bericht geliefert hat, und nicht offengelegt, wo die Beweise nicht mehr feststellen konnten.
Gleichzeitig ist nicht Kausalität. Ähnliche Symptome oder sich überschneidende Zeitpunkte beweisen keinen gemeinsamen Cloud-Anbieter, Carrier, Cyberangriff, Sabotageereignis oder Versager eines Anbieters. Teilweise Verfügbarkeit ist auch kein Beweis für Unschädlichkeit: Ein Geldautomat, eine Kartenroute, eine alternative Nummer oder ein Textkanal kann Berechtigungen, Kapazität, Zugänglichkeit oder geografische Einschränkungen haben. Schließlich beschreiben die regulatorischen Quellen in diesem Papier ihre eigenen Sektoren und Gerichtsbarkeiten und sollten nicht als Rechtsberatung gelesen werden.
Fazit
Ein resilienter Dienst garantiert nicht, dass jede Komponente für immer verfügbar bleibt. Er macht Abhängigkeitsgrenzen sichtbar, begrenzt den Explosionsradius, bewahrt definierte kritische Ergebnisse, wo es sicher ist, kommuniziert, was Benutzer tun können und was nicht, und erklärt die Wiederherstellung erst nach der Verifizierung als abgeschlossen. Für Führungskräfte, die die jüngsten Ausfalltrends überprüfen, ist sanfte Degradation keine weichere Version von Verfügbarkeit; sie ist die operationale Disziplin, die konzentrierte Abhängigkeiten in begrenzte, messbare Risiken verwandelt.
Quellen
- Status Is Down: Microsoft 365 Ausfall lässt kleinen Teil betroffen in den dritten Tag; ChatGPT Arbeit erholt sich nach fünfstündiger Unterbrechung
- Status Is Down: ChatGPT und Claude Ausfälle treffen KI-Nutzer, während die Berichte sich über Gemini, Copilot und Grok verbreiten
- Status Is Down: Kuba beginnt mit der Wiederherstellung des Stromnetzes nach dem landesweiten Blackout; Sharetec-Ausfall stört Kreditgenossenschaften
- Status Is Down: J:COM stellt Breitband nach weitreichender Störung in Japan wieder her; NAB löst Ausfall des digitalen Bankings
- Status Is Down: Nordost-Flughafendienstleistungen werden nach Telekommunikationsausfall wieder aufgenommen; die Wiederherstellung der Michigan-Staatsversorgung dauert an
- Status Is Down: Mastercard-Zahlungen weltweit schlagen fehl: fünf Verarbeiter berichten über Fehler, bevor die Wiederherstellung beginnt
- Status Is Down: Monzo aktiviert Backup-Bank mitten im Ausfall der App im Vereinigten Königreich; IndiGo-Reservierungsfehler blockiert Buchungen in Indien
- Status Is Down: Oklahoma stellt 911-Routing nach Netzwerkproblemen wieder her; umgestürzte Masten stören den Long Island-Bahnverkehr
- Google Cloud: Mehrere GCP-Produkte haben Serviceprobleme
- Cloudflare: Cloudflare-Ausfall am 18. November 2025
- Uptime Institute: Jahresbericht zur Ausfallanalyse 2026
- National Institute of Standards and Technology: Das NIST Cybersecurity Framework (CSF) 2.0
- Financial Conduct Authority: Betriebliche Resilienz: Einsichten und Beobachtungen für Unternehmen
- Federal Communications Commission: 911 Verfügbarkeit
- Australian Prudential Regulation Authority: Prudential Standard CPS 230 Operational Risk Management
- European Insurance and Occupational Pensions Authority: Digital Operational Resilience Act (DORA)
- Federal Financial Institutions Examination Council: Business Continuity Management: Interdependency Analysis
Bildernachweis: Illustration für Status Is Down generiert