Kiedy «Down» nie oznacza «Zniknął»: Projektowanie eleganckiej degradacji w przypadku skoncentrowanych uzależnień cyfrowych
Większość raportów o awariach zaczyna się od pytania binarnego: czy usługa działa, czy jest niedostępna? Niedawne incydenty międzysektorowe wskazują na bardziej użyteczne pytanie dla liderów technologii, ryzyka i operacji: które wyniki dla klientów nadal działają, gdy wspólna zależność zawodzi, i jak organizacja będzie wiedzieć, kiedy odzyskanie jest naprawdę zakończone?
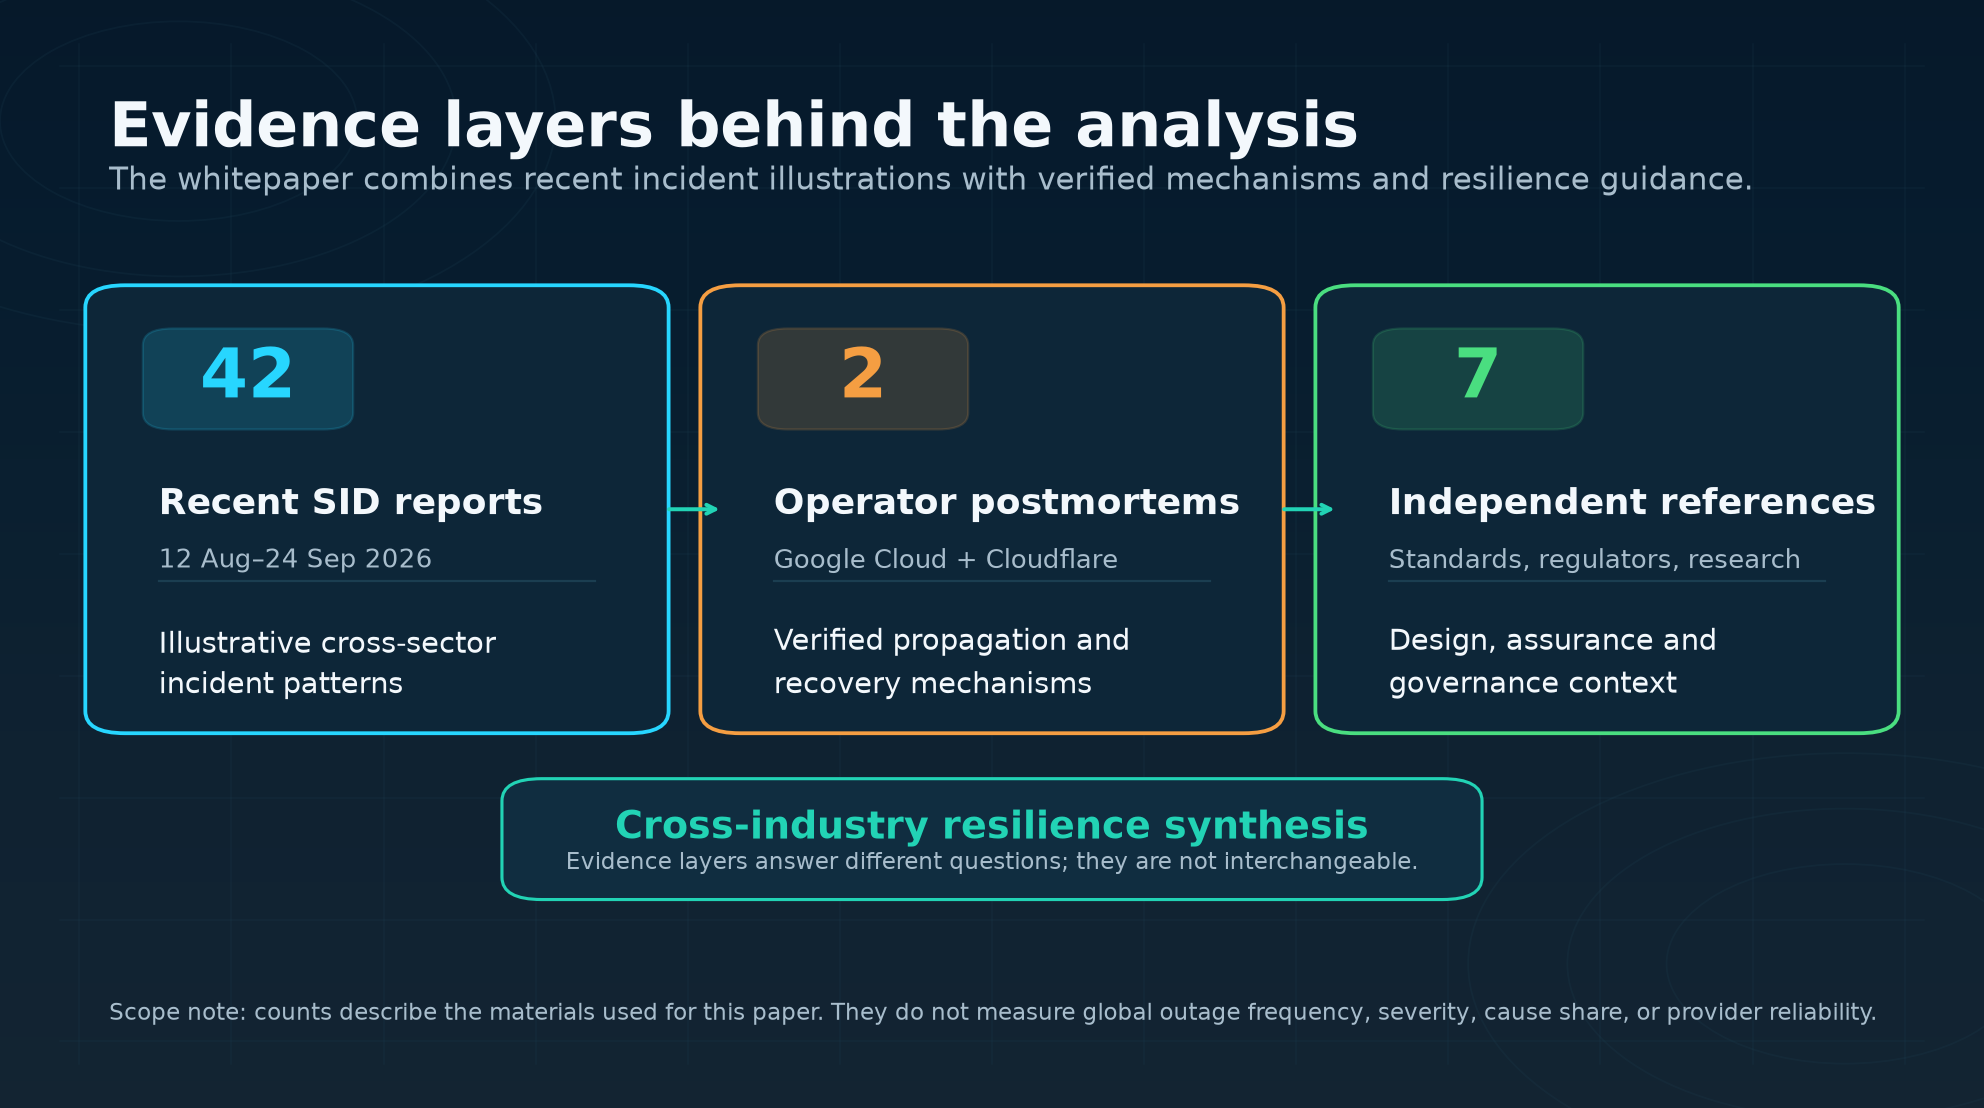
Niniejszy dokument analizuje 42 posty redakcyjne Status Is Down opublikowane od 12 sierpnia do 24 września 2026 roku, a następnie porównuje te ilustracje z post-mortem operatorów i regulacjami lub standardami. Korpus nie jest statystycznie reprezentatywnym globalnym zestawem danych o awariach, więc nie można ustalić częstotliwości incydentów, porównywalnej niezawodności ani dominującej przyczyny. Może jednak ujawniać powtarzające się pytania projektowe w różnych platformach chmurowych, telekomunikacji, bankowości, komunikacji awaryjnej i transporcie.
Główne ustalenie jest takie, że skuteczne skoncentrowanie zależności może przekształcić wąską awarię kontroli, środowiska, routingu, tożsamości lub przetwarzania w incydent obejmujący wiele produktów. Elegancka degradacja może zmniejszyć to narażenie, zachowując zdefiniowaną, bezpieczną i jasno komunikowaną minimalną usługę. Wytrzymałość powinna być zatem oceniana na podstawie krytycznych wyników i weryfikowanej normalizacji — a nie przez ilość dostawców, pojedynczy procent dostępności czy moment, w którym dostawca wyższej rangi ogłasza "rozwiązane".
Podsumowanie wykonawcze
Najważniejsza zależność organizacji nie zawsze jest jej najbardziej widocznym dostawcą. Może to być wspólna ścieżka autoryzacji, system dystrybucji konfiguracji, procesor rdzeniowy, system chłodzenia w centrum danych, obwód przewozowy, platforma statusowa lub kanał wsparcia. Funkcje te tworzą efektywny rdzeń zależności: mały zestaw obszarów awarii, które mogą zak interrupować wiele markowych usług lub ścieżek klientów jednocześnie.
Elegancka degradacja to praktyczny kontrapunkt. Oznacza to świadome zachowanie ograniczonego, bezpiecznego i zrozumiałego wyniku podczas uszkodzenia. Nie oznacza to cichego zaakceptowania niższej jakości usługi, zakładając, że jeden alternatywny kanał działa dla każdego klienta, ani ogłaszania sukcesu, gdy gromadzą się kolejki i prace związane z reconciliacją. Tryb degradacji wymaga wyraźnych granic w zakresie pojemności, integralności i komunikacji z klientem, a następnie zweryfikowanego powrotu do normalnej pracy.
Gdzie kryje się koncentracja
Koncentracja logiczna może być równie ważna jak uszkodzony kabel czy awaria zasilania. W raporcie Microsoft 365 i ChatGPT Work Microsoft przypisał ciągły wpływ problemowi z konfiguracją autoryzacji, który dotknął Exchange Online oraz związane usługi współpracy i bezpieczeństwa. Wydarzenie związane z ChatGPT opisane w tym samym artykule było odrębne; bliskość czasowa nie ustaliła wspólnej przyczyny. W późniejszym raporcie AI z wieloma dostawcami zastosowano tę samą ochronę: jednoczesne incydenty produktowe nie były dowodem jednej wspólnej awarii w chmurze.
Dwa postmortem pierwszej strony pokazują, jak propagacja może wzmocnić wąską zmianę. Google Cloud zgłosił, że niezamierzone puste pola w danych polityki kwotowej powielają się globalnie w ciągu sekundy, wykorzystując niewystarczająco chronioną ścieżkę kodu Kontroli Usług i powodując pętle awarii. Większość regionów zaczęła się regenerować po wyłączeniu ścieżki polityki, podczas gdy efekt zbiorowego ponownego uruchomienia wydłużył czas regeneracji w dużym regionie, a niektóre produkty miały pozostałe zaległości. Google również stwierdził, że infrastruktura zdrowia i niektóre systemy monitorowania klientów były uszkodzone.
Cloudflare oddzielnie prześledził swój incydent z listopada 2025 roku do zmiany uprawnień do bazy danych, która podwoiła plik funkcji Zarządzania Botami. Zbyt duży plik rozprzestrzenił się w sieci i przekroczył limit oprogramowania. Cloudflare wyraźnie wykluczył cyberatak. Rdzenia ruchy były w dużej mierze normalne do 14:30 UTC, ale wszystkie systemy nie zostały zgłoszone jako normalne do 17:06 UTC. Mechanizmy te nie wyjaśniają incydentów z 2026 roku; pokazują, dlaczego generowanie konfiguracji, walidacja, wdrożenie, wycofanie i obserwowalność należą do modelu awarii produkcji.
Skoncentracja fizyczna i operacyjna może również zniweczyć nominalną kopię zapasową. W przypadku incydentu telekomunikacyjnego w północno-wschodnim porcie lotniczym podstawowy obwód komunikacyjny zawiódł, gdy alternatywna trasa światłowodowa była również niedostępna po przycięciu. Naprawy pozwoliły na wznowienie operacji, ale zgromadzone zakłócenia lotów pozostały. Druga linia na diagramie nie jest dowodem odporności, jeśli dzieli korytarz, obiekt, płaszczyznę kontrolną, źródło zasilania lub ograniczenia naprawcze z pierwszą.
Częściowa usługa nie oznacza dostępności
Przykłady z finansów pokazują, dlaczego wyniki klientów powinny być oceniane osobno. Podczas problemu z aplikacją w Wielkiej Brytanii, raport Monzo opisuje niezależny układ z bankiem rezerwowym oraz ciągłe płatności kartą, wypłaty gotówki, zamrażanie kart i przelewy, podczas gdy niektóre funkcje aplikacji były ograniczone. W incydencie NAB dotknięta została cyfrowa bankowość, handel i kontakt telefoniczny, podczas gdy bankomaty i szybkie płatności pozostały dostępne, a termin Direct Entry został przedłużony. Żaden z przykładów nie oznacza, że każdy klient miał odpowiedni substytut; pokazuje to, że organizacja może zaprojektować ciągłość wokół konkretnych zadań, a nie tylko jednego interfejsu.
Wspólne zależności mogą generować nierówny wpływ. Raport Status Is Down o procesorach Mastercard udokumentował różne stany procesorów i tras, bez deklarowania uniwersalnej awarii płatności lub ostatecznej przyczyny technicznej. Raport Sharetec opisuje zakłócenia specyficzne dla instytucji po tym, jak dotknięte przez to instytucje kredytowe przypisują incydent problemom z chłodzenie i awarią w wspólnym dostawcy usług rdzeniowych. Przywrócenie rdzenia nie oznaczało automatycznie, że salda, bankowość cyfrowa i wszystkie workflowy członków zostały uzgodnione w tym samym czasie.
To ramowanie skoncentrowane na wynikach znajduje odzwierciedlenie w APRA CPS 230. Dla regulowanych instytucji australijskich wymaga to tolerancji na maksymalne zakłócenia, utratę danych i minimalną usługę w ramach alternatywnych ustaleń dla krytycznych operacji. FFIEC również nawołuje do analizy pojedynczych punktów awarii i zależności w ramach przetwarzania rdzeniowego, bankowości internetowej i mobilnej, zawierania, usług użyteczności i stron trzecich. To wymogi i wytyczne specyficzne dla danej branży, a nie uniwersalne przepisy prawne, ale zasada projektowa ma zastosowanie: zdefiniuj zadanie, które musi być kontynuowane, zanim wybierzesz zapas.
Komunikacja awaryjna i transport ujawniają ryzyko specyficzne dla ścieżki
Komunikacja awaryjna to nie jedna ścieżka. Raport Oklahoma 911 odróżnia zakończenie połączeń przewodowych od problemów z routowaniem bezprzewodowym i opisuje alternatywne linie dziesięciocyfrowe oraz transfery używane podczas zakłócenia. Nie ustalono, że każde centrum obsługi w Oklahomie zawiodło jednocześnie, a żadne z recenzowanych źródeł nie dostarczyło całkowitej liczby nieudanych połączeń ani bardziej szczegółowej przyczyny. Podobna ostrożność jest potrzebna, gdy tylko głos, tekst, dane o lokalizacji, routing i lokalne dostarczanie przez centrum obsługi mogą mieć różne stany.
W Stanach Zjednoczonych, FCC wymaga, aby dostawcy, których to dotyczy, kończyli połączenia 911, przesyłali informacje o lokalizacji, zajmowali się różnorodnością obwodów, zasilaniem awaryjnym i monitorowaniem oraz informowali dotknięte obiekty 911 o awariach, które mogą je dotknąć. Te zasady są specyficzne dla jurysdykcji. Podczas jakiegokolwiek aktywnego zakłócenia usług awaryjnych, czytelnicy powinni kierować się aktualnymi instrukcjami od odpowiednich organów lokalnych, a nie traktować ogólnej strony monitorowania lub stron z wiadomościami jako substytutu.
Systemy transportowe czynią ogon regeneracji widocznym. Przywrócone komunikacje mogą ponownie otworzyć ścieżkę operacyjną, podczas gdy samoloty, załogi i pasażerowie pozostają poza pozycją. Naprawiona infrastruktura kolejowa może umożliwić świadczenie usług, podczas gdy nadal występują opóźnienia. Lekcja nie polega na tym, że każdy incydent transportowy ma wspólną przyczynę; chodzi o to, że status majątku umożliwiającego a status publicznego wyniku są różnymi faktami operacyjnymi.
Odzyskiwanie to sekwencja, a nie etykieta
Precyzyjny język odzyskiwania zmniejsza fałszywe poczucie bezpieczeństwa i ułatwia weryfikację. Praktyczny model czterostopniowy to:
- Izolacja: awaria jest izolowana lub jej propagacja jest zatrzymana.
- Przywrócenie minimalnej zdolności: zdefiniowany krytyczny wynik lub bezpieczna alternatywna ścieżka jest dostępna w określonych granicach.
- Normalizacja w toku: kolejki, opóźnione zadania, regionalna pojemność, wsparcie klientów, spójność danych i zależne przepływy pracy są usuwane lub sprawdzane.
- Odzyskanie uznane za zakończone: integralność i normalny status operacyjny zostały zweryfikowane w stosunku do wyraźnych kryteriów zamknięcia.
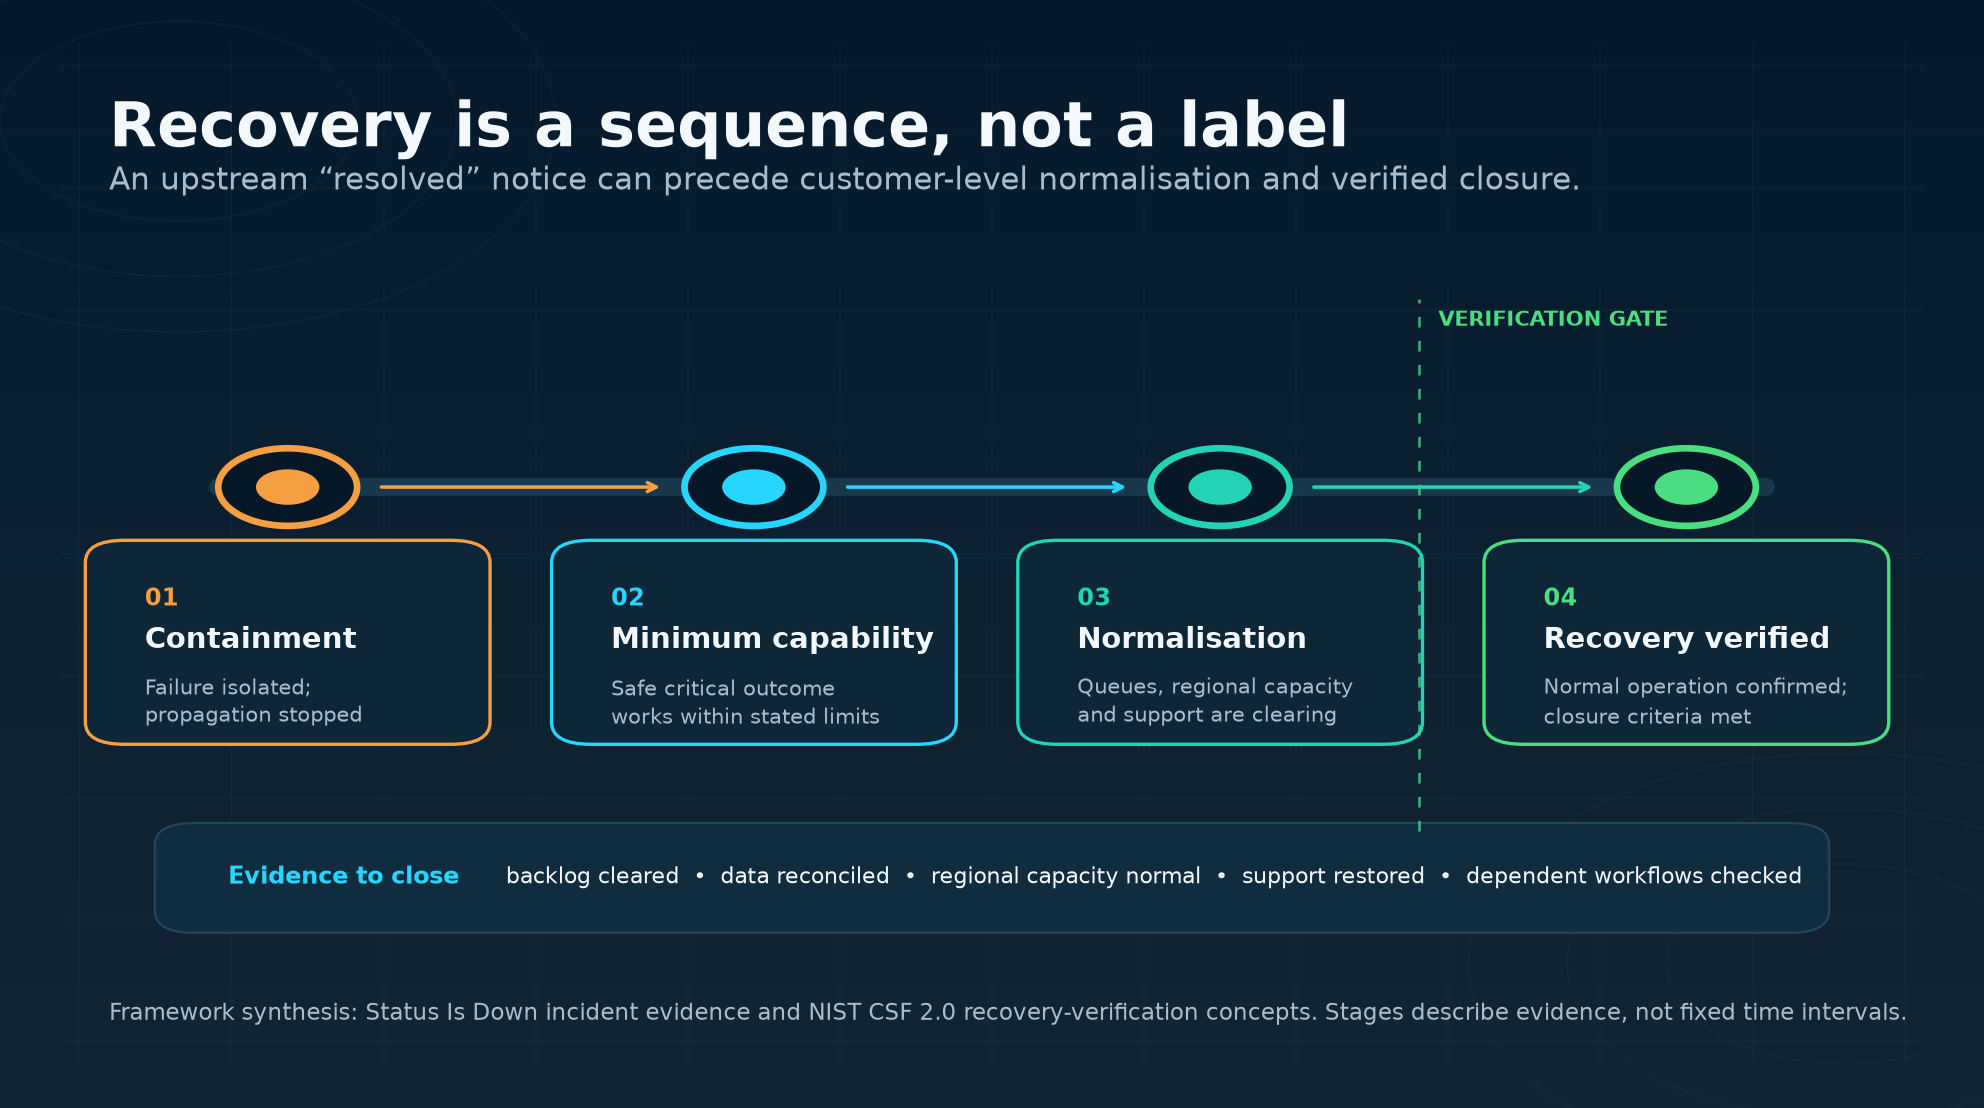
Ta różnica pojawia się w dowodach dotyczących incydentów. J:COM zgłosił recovery usługi, podczas gdy połączenia do centrum obsługi klientów pozostały trudne. Naprawa telekomunikacji na lotnisku pozwoliła na wznowienie operacji przed normalizacją rozkładów. Google Cloud i Cloudflare zarejestrowali lukę między szeroką lub rdzeniową regeneracją a końcem resztkowych efektów.
W ramach NIST Cybersecurity Framework 2.0 formalizuje krok weryfikacji dla incydentów cybernetycznych: działania związane z odzyskiwaniem są wybierane i priorytetowane, zasoby przywracające są sprawdzane, integralność przywracanych zasobów i normalny status operacyjny są potwierdzane, a koniec odzyskiwania uznawany jest za zakończony w odniesieniu do kryteriów. Ta sama dyscyplina jest użyteczna także poza cyberbezpieczeństwem, nawet gdy incydent zaczyna się od zasilania, chłodzenia, telekomunikacji lub błędu operacyjnego.
Pięcioelementowy program eleganckiej degradacji
Po pierwsze, zmapuj ważny rezultat i każdy obszar awarii, który go umożliwia. Podążaj za tożsamością, DNS, dostarczaniem krawędziowym, płaszczyznami kontrolnymi, API, procesorami, centrami danych, przewoźnikami, monitorowaniem i wsparciem, w tym czwarte strony i fizyczne trasy. Ramowy akt DORA UE traktuje skoncentrowanie krytycznych ICT od zewnętrznych jako kwestię odporności operacyjnej w finansach; inne branże mogą używać tej samej soczewki analitycznej, nie zakładając, że regulacja ma zastosowanie do nich.
Po drugie, zdefiniuj minimalny wykonalny tryb. Określ, które zadania klientów kontynuują, jakie dane mogą być opóźnione, kto ma priorytet, jaki limit pojemności ma zastosowanie i jak prace odroczone będą uzgadniane. Alternatywa, która jest niebezpieczna, niedostępna lub zbyt mała dla popytu, nie jest wiarygodną usługą w trybie degradacji.
Po trzecie, zaprojektuj izolację i przełączanie awaryjne. W zależności od systemu, kontrole mogą obejmować stopniowe wdrożenie, walidację, flagi funkcji, przełączniki awaryjne, ograniczone ponowne próby, losowe eksponowane odroczenie, wyłączniki obwodów, kolejki, pamięci podręczne, polityki sesji i ręczne obejścia. Post-mortem Google zidentyfikował kilka z nich jako obszary remediów; dokładny zestaw sterujących musi odpowiadać usłudze i jej ryzyku.
Po czwarte, zachowaj niezależną obserwowalność i komunikację. Strona statusu, stos monitorujący i kanał wsparcia mogą dzielić tę samą zależność, co produkcja. Organizacje powinny zidentyfikować oddzielny sposób obserwowania wyników klientów i publikować zatwierdzone aktualizacje, które rozróżniają objawy, potwierdzony zakres, status przyczyny, obejścia, przywrócenie zdolności, normalizację i zamknięcie.
Po piąte, przetestuj wspólną awarię. Wytyczne FCA dotyczące odporności operacyjnej proszą firmy objęte przepisami o zmapowanie ludzi, procesów, technologii, obiektów, informacji i stron trzecich, a następnie przetestowanie poważnych, ale prawdopodobnych scenariuszy. Rozróżnia także cele czasowe odzyskiwania od tolerancji wpływu i zauważa, że działania reagujące mogą zyskać czas, podczas gdy odzyskiwanie się kończy. Użyteczne ćwiczenie powinno zatem łączyć testy utraty zależności, częściowej usługi, niedostępnych normalnych komunikacji, obciążeń wsparcia i usuwania zaległości — nie tylko to, czy serwer kopi zapasowej uruchamia się.
Miary, które mogą wykorzystać zarządy
Pojedynczy procent dostępności nie może pokazać, czy klient zakończył płatność, dotarł do służb awaryjnych, odprawił się na lot czy uzyskał dostęp do krytycznej funkcji konta. Miary oparte na wynikach mogą obejmować czas wykrywania, czas do pierwszej używalnej alternatywy, procent lub objętość krytycznych zadań ukończonych bezpiecznie, wiek kolejki, wyjątki w reconciliacji, dostępność kanału wsparcia, czas do zweryfikowanych normalnych operacji i nierozwiązane ryzyka związane z odzyskiwaniem.
Analiza za 2026 wydana przez Uptime Institute dostarcza szerszego kontekstu: raportuje, że częstotliwość awarii na miejscu spadła po raz piąty, podczas gdy awarie zewnętrznych infrastruktur stały się bardziej prominentne w publicznie raportowanych awariach, a wydarzenia związane z włóknami i łącznością były bardziej prawdopodobne, że spowodują przedłużające się zakłócenia. Jego dowody łączą badania, publiczne raporty oraz członków i partnerów. Te wyniki nie powinny być traktowane jako spis całego korpusu Status Is Down, ale wzmacniają potrzebę spojrzenia poza wewnętrzny sprzęt i zmapowania zewnętrznych zależności.
Co to oznacza dla użytkowników Status Is Down
Status Is Down może wspierać tę pracę, pomagając zespołom porównywać obecne sygnały użytkownika z aktualizacjami operatorów w jego rekordach witryny, katalogu usług i panelu w czasie rzeczywistym. Te zasoby uzupełniają, a nie zastępują, oficjalne instrukcje dostawców, awaryjne czy transportowe.
Utworzenie konta i wybór planu monitorowania mogą pomóc zespołom śledzić zewnętrzne usługi, na których polegają, oraz dodać kontekst do ich własnej telemetrii. Większe zadanie w zakresie odporności pozostaje organizacyjne: zdefiniować krytyczny wynik, przetestować tryb degradacji i zweryfikować drogę powrotu do normy. Czytelnicy mogą również eksplorować dodatkowe badania w kolekcji Białych Ksiąg branżowych.
Metodologia i ograniczenia
Materiał Status Is Down użyty tutaj jest editorialnie wybranym, źródłowo powiązanym zbiorem, a nie badaniem rozpowszechnienia. Liczby artykułów nie mogą wspierać twierdzeń na temat częstotliwości, nasilenia, geografii, czasu trwania, porównywalnej niezawodności czy udziału przyczyny. Równoczesne raporty mogą być również zmieniane przez późniejszą analizę operatora. Język dotyczący przyczyny pozostaje zatem wąski: potwierdzony, gdzie istnieje post-mortem, przypisany, gdzie operator lub instytucja dostarczyli relację, oraz nieujawniony, gdy dowody nie ustaliły więcej.
Równoczesność to nie przyczyna. Podobne objawy lub nachodzący czas nie udowadniają wspólnej chmury, przewoźnika, ataku cybernetycznego, sabotażu czy awarii dostawcy. Częściowa dostępność nie jest również dowodem na bezwładność: bankomat, trasa kart, alternatywny numer czy kanał tekstowy mogą mieć ograniczenia dotyczące uprawnień, pojemności, dostępności czy geograficznych. Wreszcie, źródła regulacyjne w tym artykule opisują swoje własne sektory i jurysdykcje i nie powinny być interpretowane jako porady prawne.
Podsumowanie
Usługa odporna nie obiecuje, że każdy element pozostanie dostępny na zawsze. Ujawni granice zależności, ograniczy promień uderzenia, zachowa zdefiniowane krytyczne wyniki tam, gdzie jest to bezpieczne, przekazuje, co użytkownicy mogą i czego nie mogą zrobić, oraz ogłasza zakończenie odzyskiwania tylko po weryfikacji. Dla liderów przeglądających niedawne trendy w awariach elegancka degradacja to nie łagodniejsza wersja dostępności; to dyscyplina operacyjna, która przekształca skoncentrowane zależności w ograniczone, mierzalne ryzyko.
Źródła
- Status Is Down: Awaria Microsoft 365 pozostawia małą podgrupę dotkniętą do trzeciego dnia; ChatGPT Work regeneruje się po pięciogodzinnym zakłóceniu
- Status Is Down: Awaria ChatGPT i Claude dotyka użytkowników AI, gdy raporty rozprzestrzeniają się w Gemini, Copilot i Grok
- Status Is Down: Kuba zaczyna regenerację po ogólnokrajowym czarnymoutsie; Awaria Sharetec zakłóca działalność instytucji kredytowych
- Status Is Down: J:COM przywraca szerokopasmowy dostęp po powszechnym zakłóceniu w Japonii; NAB rozwiązuje awarię bankowości cyfrowej
- Status Is Down: Operacje na północno-wschodnim lotnisku wznawiają się po awarii telekomunikacyjnej; regeneracja użyteczności Michigan State trwa
- Status Is Down: Awaria płatności Mastercard na całym świecie: pięciu procesorów zgłasza błędy przed rozpoczęciem regeneracji
- Status Is Down: Monzo aktywuje bank rezerwowy w obliczu awarii aplikacji w Wielkiej Brytanii; usterka rezerwacji IndiGo blokuje rezerwacje w Indiach
- Status Is Down: Oklahoma przywraca routowanie 911 po problemie z siecią; upadłe słupy zakłócają usługi kolejowe Long Island
- Google Cloud: Wiele produktów GCP doświadcza problemów z usługą
- Cloudflare: Awaria Cloudflare 18 listopada 2025 roku
- Uptime Institute: Coroczny raport o analizie awarii 2026
- Narodowy Instytut Standardów i Technologii: NIST Cybersecurity Framework (CSF) 2.0
- Urząd ds. Praktyki Finansowej: Odporność operacyjna: spostrzeżenia i uwagi dla firm
- Federalna Komisja Łączności: Niezawodność 911
- Australijski Urząd Regulacji Prudencyjnej: Standard Prudencyjny CPS 230 w zarządzaniu ryzykiem operacyjnym
- Europejski Urząd Nadzoru Ubezpieczeń i Pracowniczych: Akt w sprawie cyfrowej odporności operacyjnej (DORA)
- Rada Nadzoru Instytucji Finansowych: Zarządzanie ciągłością działalności: analiza współzależności
Źródło ilustracji: Ilustracja stworzona dla Status Is Down