Kapag ang ‘Down’ ay Hindi ‘Nawala’: Pagdidisenyo ng Maayos na Pagbagsak para sa Naka-concentrate na Digital Dependencies
Karamihan sa mga ulat ng outage ay nagsisimula sa isang binary na tanong: ang serbisyo ba ay up o down? Ang mga kamakailang insidente mula sa iba't ibang sektor ay tumuturo sa isang mas kapaki-pakinabang na tanong para sa mga lider ng teknolohiya, peligro at operasyon: ano ang mga resulta ng customer na patuloy na gumagana kapag nabigo ang isang ibinahaging dependency, at paano malalaman ng organisasyon kung ang pagbawi ay talagang kumpleto?
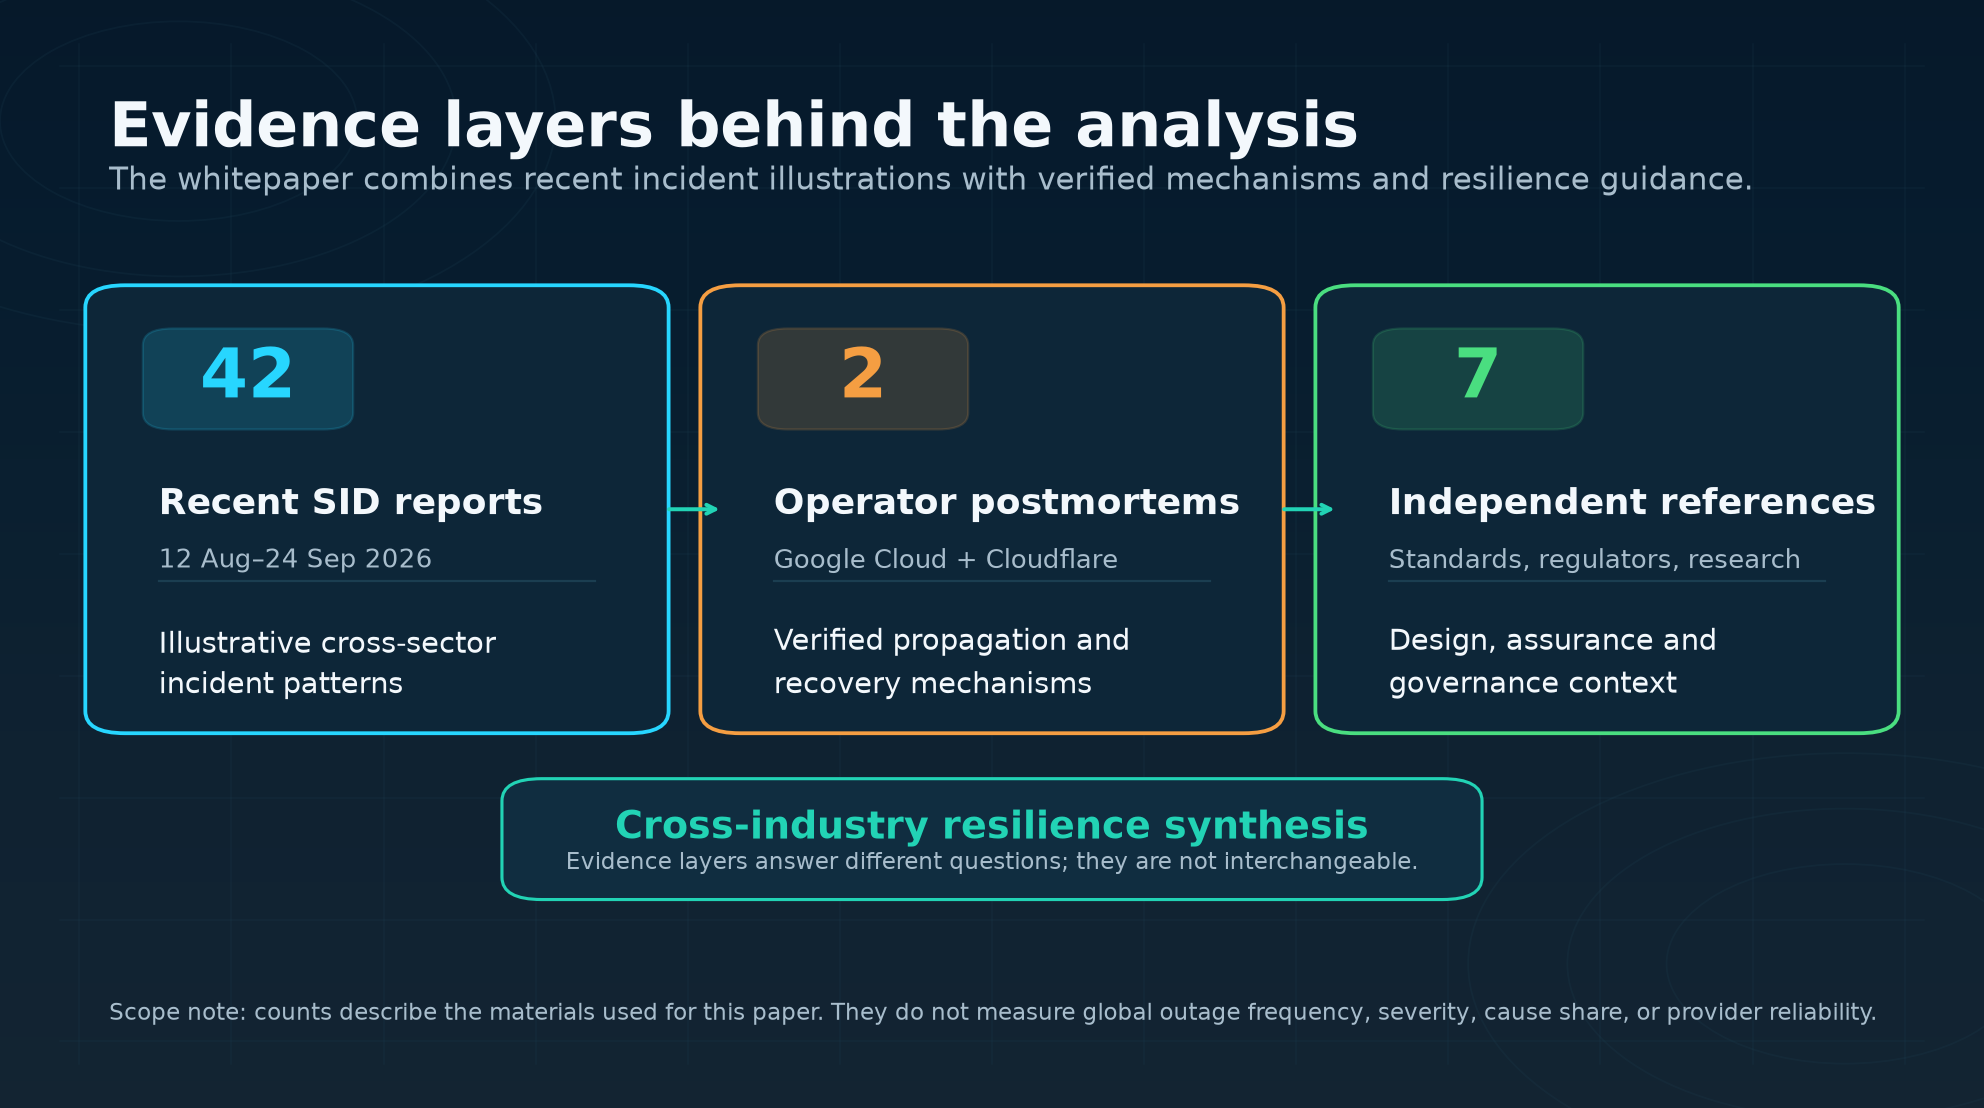
Sinusuri ng whitepaper na ito ang isang corpus ng 42-post na editoryal mula sa Status Is Down na nailathala mula 12 Agosto hanggang 24 Setyembre 2026, pagkatapos ay inihahambing ang mga ilustrasyon na iyon sa mga postmortem ng operator at patnubay mula sa regulasyon o mga pamantayan. Ang corpus ay hindi isang estadistikang kumakatawan sa pandaigdigang dataset ng outage, kaya hindi nito maitatag ang dalas ng insidente, komparatibong pagiging mapagkakatiwalaan o isang nangingibabaw na sanhi. Gayunpaman, maaari nitong ilantad ang mga paulit-ulit na katanungan sa disenyo sa iba't ibang cloud platform, telekomunikasyon, banking, emergency communications at transportasyon.
Ang pangunahing natuklasan ay ang epektibong konsentrasyon ng dependency ay maaaring gawing masikip na kontrol, kapaligiran, routing, pagkakakilanlan o pagkabigo sa pagproseso sa isang multi-product na insidente. Ang maayos na pagbagsak ay maaaring bawasan ang nganong pagkakalantad sa pamamagitan ng pag-iingat ng isang tinukoy, ligtas at malinaw na ipinahayag na minimum na serbisyo. Samakatuwid, ang tibay ay dapat suriin ayon sa mga kritikal na resulta at nakumpirmang normalisasyon—hindi ayon sa bilang ng mga supplier, isang porsyento ng pagkakaroon o ang sandali na ang upstream provider ay nag-post ng "naresolba."
Buod ng Ehekutibo
Ang pinakamahalagang dependency ng isang organisasyon ay hindi palaging ang pinaka-kitang vendor. Maaaring ito ay isang ibinahaging daan ng autentikasyon, isang sistema ng pamamahagi ng pagsasaayos, isang core processor, isang datacenter cooling plant, isang carrier circuit, isang status platform o isang channel ng suporta. Ang mga function na ito ay bumubuo ng isang epektibong dependency core: isang maliit na set ng mga domain ng pagkabigo na maaaring makagambala sa maraming branded na serbisyo o customer journeys nang sabay-sabay.
Ang maayos na pagbagsak ay ang praktikal na tugon. Ibig sabihin nito ay maingat na pag-iingat ng isang limitadong, ligtas at madaling maunawaan na kinalabasan sa panahon ng impairment. Hindi ito nangangahulugang tahimik na pagtanggap ng nakababa na serbisyo, na kung saan ang isang alternatibong channel ay gumagana para sa bawat customer, o pagpapahayag ng tagumpay habang ang mga pila at mga gawain ng pagkakasundo ay nag-iipon. Ang mode ng pagbagsak ay nangangailangan ng tahasang kapasidad, integridad at mga hangganan sa pakikipag-ugnayan sa customer, na susundan ng isang nakumpirmang pagbabalik sa normal na operasyon.
Saan nagkukubli ang konsentrasyon
Ang lohikal na konsentrasyon ay maaaring kasing-maimpluwensiya ng isang nasirang cable o nabigong power supply. Sa ulat ng Microsoft 365 at ChatGPT Work mula sa Status Is Down, itinuro ng Microsoft ang patuloy na epekto sa isang isyu ng core authentication configuration na umabot sa Exchange Online at mga konektadong serbisyong kolaborasyon at seguridad. Ang insidente ng ChatGPT na inilalarawan sa parehong artikulo ay hiwalay; ang lapit sa oras ay hindi nagtatag ng isang pangkaraniwang sanhi. Isang sumunod na multi-provider AI report ang nagpatupad ng parehong proteksyon: ang sabay-sabay na mga insidente ng produkto ay hindi ebidensya ng isang ibinahaging pagkabigo sa cloud.
Dalawang postmortem mula sa unang partidong nagpapakita kung paano maaaring lakasin ng pagpapakalat ang isang masikip na pagbabago. Iniulat ng Google Cloud na ang mga hindi sinasadyang blangkong patlang sa data ng quota-policy ay mabilis na naiparami sa buong mundo, ginamit ang isang hindi sapat na protektadong Service Control code path at nagdulot ng mga crash loops. Karamihan sa mga rehiyon ay nagsimulang makabawi pagkatapos na mapagana ang landas ng polisiya, habang ang isang restart herd effect ay nagpalawig ng pagbawi sa isang malaking rehiyon at ang ilang produkto ay nagkaroon ng natitirang backlogs. Sinabi din ng Google na ang kalusugan at ilang imprastraktura para sa pagmomonitor ng customer ay naapektuhan.
Ang Cloudflare ay hiwalay na nag-ugnay ng insidente nito noong Nobyembre 2025 sa isang pagbabago sa pahintulot ng database na nagdoble sa isang tampok na file ng Pamamahala ng Bot. Ang napakalaking file ay kumalat sa buong network at lumampas sa isang limitasyon ng software. Tiniyak ng Cloudflare na wala silang ebidensya ng cyberattack. Ang pangunahing trapiko ay naging halos normal sa 14:30 UTC, ngunit ang lahat ng sistema ay hindi iniulat na normal hanggang 17:06 UTC. Ang mga mekanismong ito ay hindi nagpapaliwanag ng mga insidente noong 2026; ipinapakita nila kung bakit ang pagbuo ng configuration, pagpapatunay, rollout, rollback at observability ay bahagi ng modelo ng pagkabigo sa produksyon.
Ang pisikal at operasyon na konsentrasyon ay maaari ding talunin ang isang nominal na backup. Sa insidente ng telekomunikasyon sa Northeast airport, nagfail ang isang pangunahing circuit ng komunikasyon habang ang isang backup na fiber route ay hindi rin magamit matapos maputol. Ang pagkukumpuni ay pinayagan ang mga operasyon na magpatuloy, ngunit nanatili ang naipong pagkaabala sa flight. Ang pangalawang linya sa isang diagram ay hindi ebidensya ng tibay kung ito ay nagbabahagi ng isang corridor, pasilidad, control plane, pinagmumulan ng kapangyarihan o limitasyon sa pagkukumpuni kasama ng una.
Ang partial na serbisyo ay hindi pareho sa availability
Ipinaalam ng mga kaso sa pananalapi kung bakit dapat suriin nang hiwalay ang mga resulta ng customer. Sa panahon ng impairment ng isang application sa UK, inilarawan ng ulat ng Monzo ang isang independent backup-bank arrangement at patuloy na mga pagbabayad ng card, mga withdrawal ng cash, pag-freeze ng card at mga paglilipat habang ang ilang mga function ng app ay limitado. Sa insidente ng NAB, naapektuhan ang digital banking, trading at pakikipag-ugnayan sa telepono, habang ang mga ATM at mabilis na pagbabayad ay nanatiling available at ang isang Direct Entry deadline ay pinalawig. Walang halimbawa ang nangangahulugang ang bawat customer ay may sapat na kapalit; ipinapakita lamang nito na ang isang organisasyon ay maaaring magdisenyo ng pagpapatuloy sa paligid ng mga tiyak na gawain sa halip na isang front end.
Ang mga ibinahaging dependency ay maaaring magdulot ng hindi pantay na epekto. Ang roundup ng processor ng Mastercard mula sa Status Is Down ay nagdodokumento ng magkakaibang estado ng processor at ruta, nang hindi tumitiyak ng isang unibersal na pagkabigo sa pagbabayad o isang panghuling teknikal na sanhi. Inilarawan ng ulat ng Sharetec ang partikular na pagkaabala sa institusyon pagkatapos na iugnay ng mga naapektuhang credit unions ang insidente sa mga problema sa paglamig at failover sa isang ibinahaging provider ng core-services. Ang muling pagbuo ng core ay hindi awtomatikong nangangahulugang ang mga balanse, digital banking at bawat workflow ng miyembro ay na-reconcile nang sabay-sabay.
Ang pag-frame na nakatuon sa resulta na ito ay sumasalamin sa CPS 230 ng APRA. Para sa mga naregulang institusyon sa Australia, nangangailangan ito ng mga pagtiyak para sa maximum na pagka-abala, pagkawala ng data at minimum na serbisyo sa ilalim ng mga alternatibong arrangement para sa mga kritikal na operasyon. Ang FFIEC ay kapareho ring nagpapatawag ng pagsusuri ng mga solong puntos ng pagkabigo at mga dependency sa buong core processing, online at mobile banking, settlement, utilities at third parties. Ang mga ito ay mga kinakailangan at patnubay na tukoy sa sektor, hindi unibersal na mga legal na patakaran, ngunit ang prinsipyo ng disenyo ay mahusay na ginagalaw: tukuyin ang gawain na dapat ipagpatuloy bago pumili ng backup.
Ang emergency communications at transport ay nagpapakita ng panganib na partikular sa daan
Ang komunikasyong pang-emergency ay hindi isang daan lamang. Ang ulat ng Oklahoma 911 ay naghiwalay ng wireline na pagkumpleto ng tawag mula sa mga problema sa wireless routing at inilarawan ang mga alternatibong sampung-digit na linya at mga paglilipat na ginamit sa panahon ng pagkaabala. Hindi nito naitatag na sabay-sabay na nabigo ang bawat call center sa Oklahoma, at walang pinag-aralang pinagmulan ang nagbigay ng kabuuang nabigong tawag o mas tiyak na ugat na sanhi. Katulad na pag-iingat ang kinakailangan sa tuwing ang boses, teksto, datos sa lokasyon, routing at lokal na paghahatid ng call-center ay may iba't ibang estado.
Sa Estados Unidos, ang FCC ay nangangailangan ng mga sakop na provider na kumpletuhin ang mga tawag sa 911, ipasa ang impormasyon ng lokasyon, tukuyin ang pagkakaiba-iba ng circuit, backup na kapangyarihan at pagmamanman, at ipaalam ang mga naapektuhang pasilidad ng 911 ng mga outage na maaaring makaapekto sa kanila. Ang mga patakarang iyon ay partikular sa hurisdiksyon. Sa panahon ng anumang aktibong pagka-abala sa serbisyo ng emerhensya, dapat sundin ng mga mambabasa ang kasalukuyang mga tagubilin mula sa nauugnay na lokal na awtoridad sa halip na ituring ang isang pangkalahatang monitoring o news page bilang kapalit.
Ang mga sistema ng transportasyon ay ginagawang nakikita ang tail ng pagbawi. Ang naibalik na komunikasyon ay maaaring muling buksan ang isang operating path habang ang mga eroplano, crew at mga pasahero ay nananatiling hindi nasa wastong posisyon. Ang nairepair na imprastraktura ng riles ay maaaring magpayagan ng serbisyo habang nagpapatuloy ang nalalabing pagkaantala. Ang aral ay hindi na ang bawat insidente ng transportasyon ay may sabay-sabay na sanhi; ito ay tungkol sa pagkakaiba ng estado ng nagpapahintulot na asset at ang estado ng pampublikong kinalabasan na iba't ibang mga katotohanan sa operasyon.
Ang pagbawi ay isang sunud-sunod, hindi isang label
Pinapababa ng tumpak na wika ng pagbawi ang maling pagtitiwala at ginagawang mas madali ang pagpapatunay. Isang praktikal na modelo na may apat na yugto ay:
- Containment: ang pagkabigo ay na-isolate o ang pagpapakalat nito ay tumigil.
- Minimum na kakayahan na naibalik: isang tinukoy na kritikal na kinalabasan o ligtas na alternatibong landas ay available sa loob ng mga nakasaad na limitasyon.
- Normalisasyon sa proseso: ang mga pila, naantalang trabaho, kapasidad sa rehiyon, suporta sa customer, konsistensya ng data at mga dependent workflows ay nililinis o sinisiyasat.
- Naideklarang kumpleto ang pagbawi: ang integridad at normal na katayuan ng operasyon ay na-verify ayon sa tahasang mga pamantayan ng pagsasara.
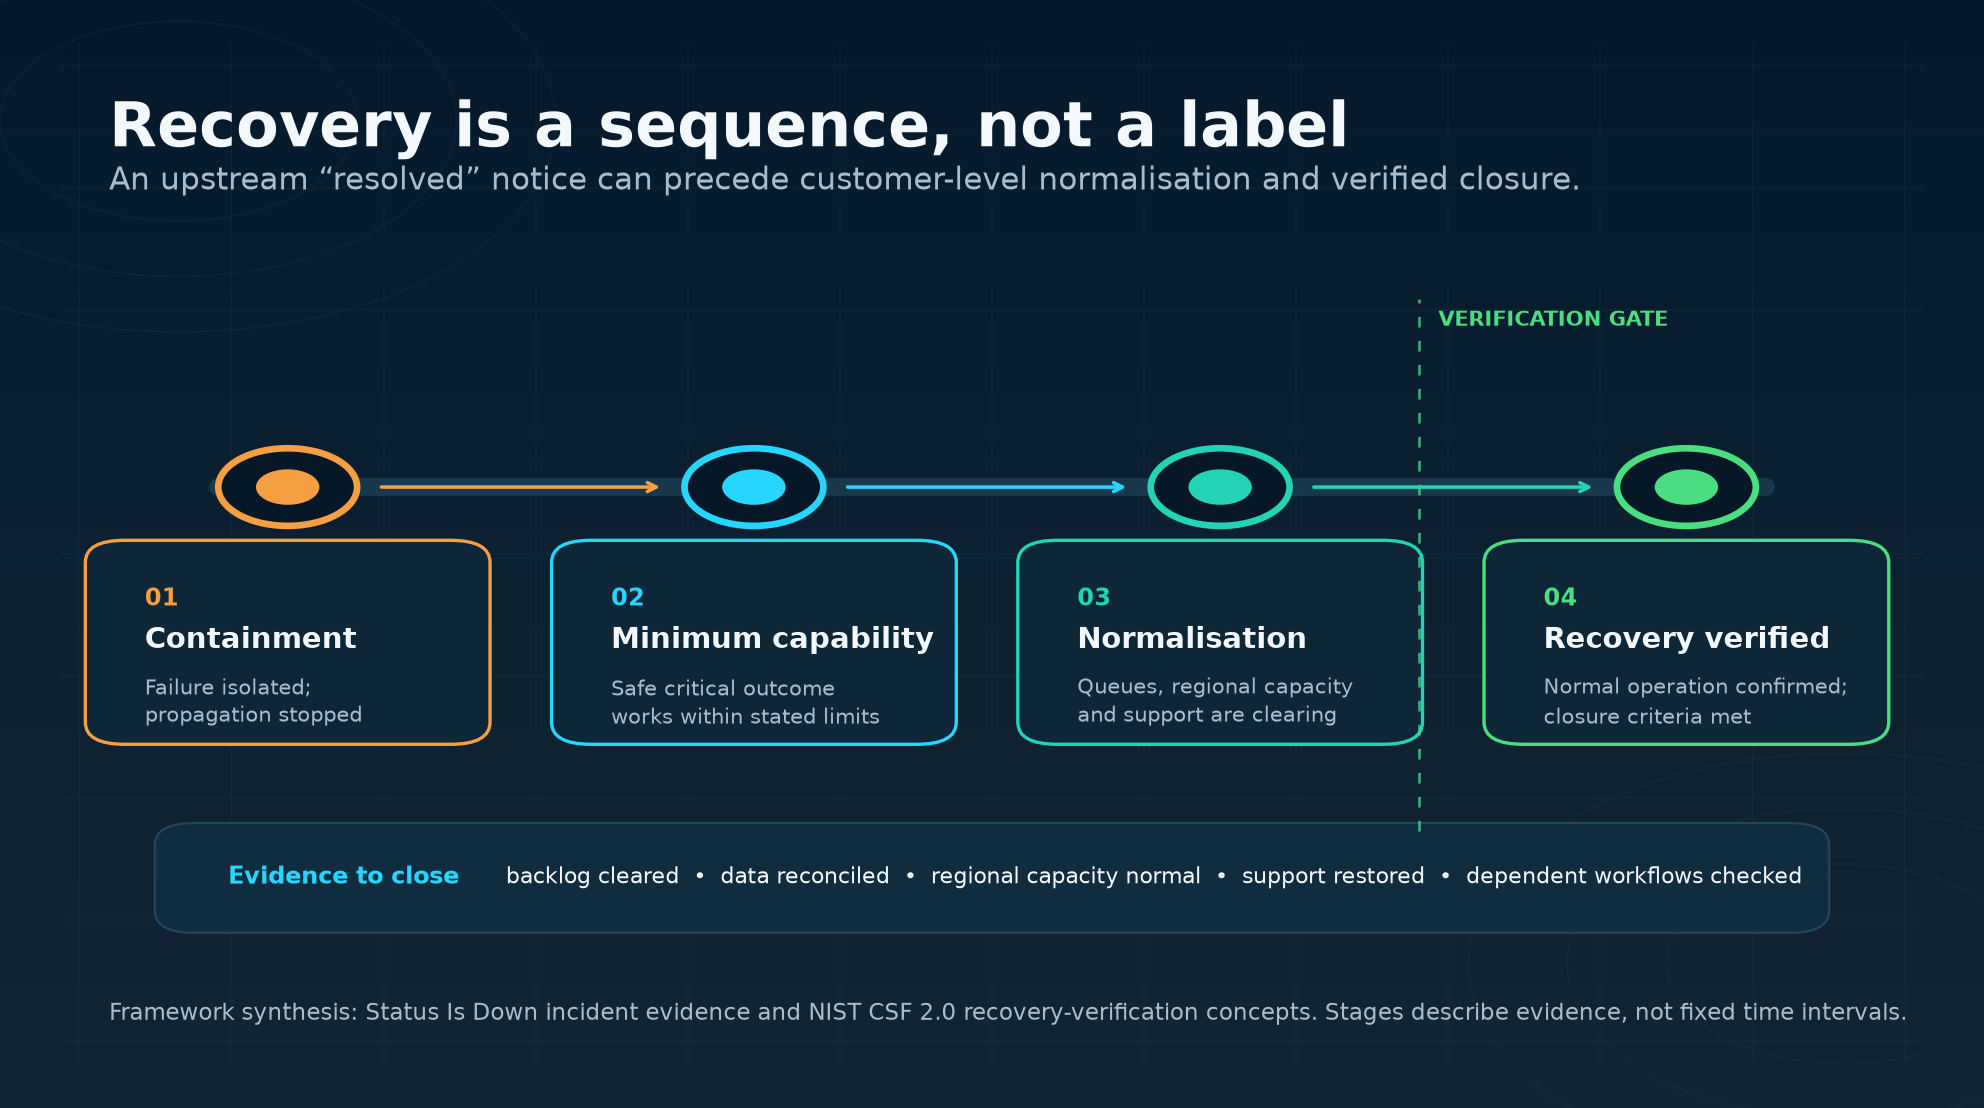
Ang pagkakaibang ito ay lumalabas sa ebidensya ng insidente. Iniulat ng J:COM ang pagbawi ng nakalistang serbisyo habang ang mga tawag sa customer-center ay nananatiling mahirap. Pinayagan ng pagkukumpuni ng telecom sa airport na ipagpatuloy ang mga operasyon bago maging normal ang mga iskedyul. Parehas na nag-ulat ang Google Cloud at Cloudflare ng isang agwat sa pagitan ng malawak o pangunahing pagbawi at ang pagtatapos ng residual effects.
Ang NIST Cybersecurity Framework 2.0 ay nagtatala ng hakbang na ito para sa cybersecurity na mga insidente: ang mga aksyon sa pagbawi ay pinili at pinaprioritize, ang mga assets sa muling pagbuo ay sinisiyasat, ang integridad ng mga naibalik na asset at ang normal na katayuan ng operasyon ay nakumpirma, at ang pagtatapos ng pagbawi ay idineklara ayon sa mga pamantayan. Ang parehong disiplina ay kapaki-pakinabang lampas sa cybersecurity, kahit na ang insidente ay nagsimula sa kapangyarihan, paglamig, telecommunications o operational error.
Isang limang bahagi na programa para sa maayos na pagbagsak
Una, i-map ang mahalagang kinalabasan at bawat domain ng pagkabigo na nagpapagana nito. Sundan ang pagkakakilanlan, DNS, edge delivery, control planes, APIs, processors, data centres, carriers, monitoring at suporta, kasama ang mga pang-apat na partido at pisikal na ruta. Ang DORA framework ng EU ay tinitingnan ang kritikal na konsentrasyon ng pangatlong partido sa ICT bilang isang alalahanin sa operational resilience sa pananalapi; ang iba pang mga sektor ay maaaring gumamit ng parehong analitikal na lens nang hindi ipinapalagay na ang regulasyon ay nalalapat sa kanila.
Pangalawa, tukuyin ang minimum na maaasahang mode. Itala kung aling mga gawain ng customer ang patuloy, kung anong data ang maaaring maantala, sino ang tumatanggap ng prayoridad, anong limitasyon ng kapasidad ang nalalapat at paano makakapag-ayos ang naantalang trabaho. Ang isang alternatibo na hindi ligtas, walang access o masyadong maliit para sa demand ay hindi isang kredibleng degraded na serbisyo.
Pangatlo, i-engineer ang containment at failover. Depende sa sistema, ang mga kontrol ay maaaring magsama ng nakasadyang rollout, pagpapatunay, feature flags, kill switches, bounded retries, randomised exponential backoff, circuit breakers, queues, caches, session policy at manual workarounds. Nakilala ng postmortem ng Google ang ilan sa mga ito bilang mga lugar ng pagwawasto; ang eksaktong kontrol na set ay dapat umangkop sa serbisyo at sa panganib nito.
Pang-apat, panatilihin ang independiyenteng observability at komunikasyon. Ang status page, monitoring stack at support channel ay maaaring magbahagi ng parehong dependency sa produksyon. Dapat tukuyin ng mga organisasyon ang isang hiwalay na paraan upang obserbahan ang mga kinalabasan ng customer at i-publish ang mga aprubadong update na nagtatangi sa mga sintomas, nakumpirmang saklaw, sanhi ng estado, mga workarounds, pag-restore ng kakayahan, normalisasyon at pagsasara.
Pang-lima, i-exercise ang pinagsamang pagkabigo. Ang patnubay sa operational resilience ng FCA ay humihiling sa mga kumpanyang sakop na pagtugmain ang mga tao, proseso, teknolohiya, pasilidad, impormasyon at mga pangatlong partido, pagkatapos ay subukan ang malubha ngunit kapani-paniwala na mga senaryo. Pinaghihiwalay din nito ang recovery time objectives mula sa impact tolerances at binibigyang-diin na ang mga aksyon sa pagtugon ay maaaring bumili ng oras habang ang pagbawi ay natatapos. Ang isang kapaki-pakinabang na pagsasanay ay dapat na subukan ang pagkawala ng dependency, partial na serbisyo, hindi magagamit na normal na komunikasyon, support overload at backlog clearance nang sabay-sabay—hindi lamang kung ang isang backup server ay nagsimula.
Mga panukala na maaaring gamitin ng mga board
Isang solong availability percentage ay hindi maipakita kung ang isang customer ay nakatapos ng pagbabayad, nakaabot ng emergency services, nag-check in para sa isang flight o nakakuha ng kritikal na function ng account. Ang mga outcome-led measures ay maaaring magsama ng oras upang matukoy, oras hanggang sa unang magagamit na contingency, ang porsyento o dami ng kritikal na gawain na natapos nang ligtas, edad ng pila, mga pagbubukod sa pagkakasundo, availability ng support channel, oras sa verified normal operations at unresolved recovery risks.
Ang 2026 analysis ng Uptime Institute ay nagbibigay ng mas malawak na konteksto: nag-uulat ito na ang dalas ng outage per site ay bumaba sa ikalimang taon, habang ang mga panlabas na pagkabigo sa imprastraktura ay naging mas prominente sa mga pampublikong naiulat na outages at ang mga insidente ng fiber at connectivity ay mas malamang na magdulot ng extended disruption. Ang ebidensya nito ay pinagsasama ang mga survey, pampublikong ulat, mga miyembro, mga kasosyo at ang sariling database nito. Ang mga natuklasan na ito ay hindi dapat ituring na census ng corpus ng Status Is Down, ngunit pinatitibay ang pangangailangan na tingnan ang lampas sa panloob na kagamitan at i-map ang mga panlabas na dependency.
Kung ano ang ibig sabihin nito para sa mga gumagamit ng Status Is Down
Maaaring suportahan ng Status Is Down ang gawaing iyon sa pamamagitan ng pagtulong sa mga koponan na ihambing ang kasalukuyang mga signal ng user sa mga update ng operator sa pamamagitan ng kanilang mga talaan ng website, directory ng serbisyo at real-time dashboard. Ang mga mapagkukunang ito ay nagsusustento, sa halip na palitan, ang opisyal na mga provider, emergency o transport instructions.
Ang paggawa ng account at pagpili ng monitoring plan ay makakatulong sa mga koponan na sundan ang mga panlabas na serbisyo na kanilang kailangan at magdagdag ng konteksto sa kanilang sariling telemetry. Ang mas malaking gawain ng tibay ay nananatiling organisasyonal: tukuyin ang kritikal na kinalabasan, subukan ang degraded mode at verify ang landas pabalik sa normal. Maaari ring galugarin ng mga mambabasa ang karagdagang pananaliksik sa koleksyon ng Industry Whitepapers.
Methodology at mga limitasyon
Ang materyal ng Status Is Down na ginamit dito ay isang editoryal na pinili, nakatali sa mga mapagkukunan, hindi isang prevalence study. Ang bilang ng artikulo ay hindi makasuporta sa mga pahayag tungkol sa dalas, tindi, heograpiya, tagal, komparatibong pagiging maaasahan o bahagi ng ugat na sanhi. Ang mga report na contemporaneous ay maaari ding ma-revised ng ibang pagsusuri ng operator. Ang wika ng sanhi ay samakatuwid ay nananatiling makitid: nakumpirma kung saan mayroong postmortem, naiuugnay kung saan ang isang operator o institusyon ay nagbigay ng ulat, at hindi naipahayag kung saan hindi naitatag ng ebidensya ang higit pa.
Ang concurrency ay hindi causality. Ang katulad na mga sintomas o overlapping timing ay hindi nagpapatunay ng isang ibinahaging cloud, carrier, cyberattack, sabotahe na kaganapan o pagkabigo ng supplier. Ang partial na availability ay hindi ring ebidensya ng kawalang pinsala: ang isang ATM, ruta ng card, alternatibong numero o text channel ay maaaring magkaroon ng eligibility, kapasidad, accessibility o geographic limits. Sa wakas, ang mga regulasyong pinagmulan sa papel na ito ay naglalarawan ng kanilang sariling mga sektor at hurisdiksyon at hindi dapat basahin bilang legal na payo.
Konklusyon
Ang isang resilient na serbisyo ay hindi nangangako na ang bawat bahagi ay mananatiling available magpakailanman. Ginagawa nitong nakikita ang mga hangganan ng dependency, pinapaliit ang blast radius, pinapanatili ang mga tinukoy na kritikal na kinalabasan kung saan ito ay ligtas, ipinaaabot ang kung ano ang magagawa at hindi magagawa ng mga gumagamit, at idinedeklara ang kumpletong pagbawi lamang pagkatapos ng pagpapatunay. Para sa mga lider na sinusuri ang mga kamakailang trend sa outage, ang maayos na pagbagsak ay hindi isang mas malambot na bersyon ng uptime; ito ay ang disiplina ng operasyon na nagpapalit ng mga naka-concentrate na dependency sa mga nakahalang, sukatan na panganib.
Mga Pinagmulan
- Status Is Down: Ang outage ng Microsoft 365 ay nag-iwan ng maliit na subset na naapektuhan sa ikatlong araw; ang ChatGPT Work ay nakabawi matapos ang limang oras na pagkaabala
- Status Is Down: Ang mga outage ng ChatGPT at Claude ay tumama sa mga gumagamit ng AI habang ang mga ulat ay kumalat sa Gemini, Copilot at Grok
- Status Is Down: Nagsimula ang Cuba ng grid recovery matapos ang nationwide blackout; Ang outage ng Sharetec ay nagdulot ng pagkaabala sa mga credit unions
- Status Is Down: Naibalik ng J:COM ang broadband matapos ang malawakang pagkaabala sa Japan; Ang NAB ay nagresolba ng outage sa digital banking
- Status Is Down: Nagsimula ang operasyon ng Northeast airport matapos ang telecom outage; ang pag-recovery ng Michigan State utility ay nagpapatuloy
- Status Is Down: Nabigo ang mga pagbabayad ng Mastercard sa buong mundo: limang processor ang nag-ulat ng mga pagkakamali bago magsimula ang pagbawi
- Status Is Down: Inactivate ng Monzo ang backup bank sa gitna ng UK app outage; Ang IndiGo reservation glitch ay humaharang sa mga booking sa India
- Status Is Down: Naibalik ng Oklahoma ang 911 routing matapos ang isyu sa network; ang mga bumagsak na poste ay nagdulot ng pagkaabala sa serbisyo ng Long Island rail
- Google Cloud: Maraming produkto ng GCP ang nakakaranas ng mga isyu sa Serbisyo
- Cloudflare: Cloudflare outage noong Nobyembre 18, 2025
- Uptime Institute: Annual Outage Analysis Report 2026
- National Institute of Standards and Technology: The NIST Cybersecurity Framework (CSF) 2.0
- Financial Conduct Authority: Operational resilience: insights and observations para sa mga kumpanya
- Federal Communications Commission: 911 Reliability
- Australian Prudential Regulation Authority: Prudential Standard CPS 230 Operational Risk Management
- European Insurance and Occupational Pensions Authority: Digital Operational Resilience Act (DORA)
- Federal Financial Institutions Examination Council: Business Continuity Management: Interdependency Analysis
Image credit: Illustration generated for Status Is Down