Cuando 'Down' No Es 'Gone': Diseñando una Degradación Elegante para Dependencias Digitales Concentradas
La mayoría de los informes de interrupción comienzan con una pregunta binaria: ¿está el servicio en línea o fuera de línea? Recientes incidentes en varios sectores apuntan a una pregunta más útil para líderes de tecnología, riesgo y operaciones: ¿qué resultados para el cliente aún funcionan cuando falla una dependencia compartida, y cómo sabrá la organización cuándo la recuperación está realmente completa?
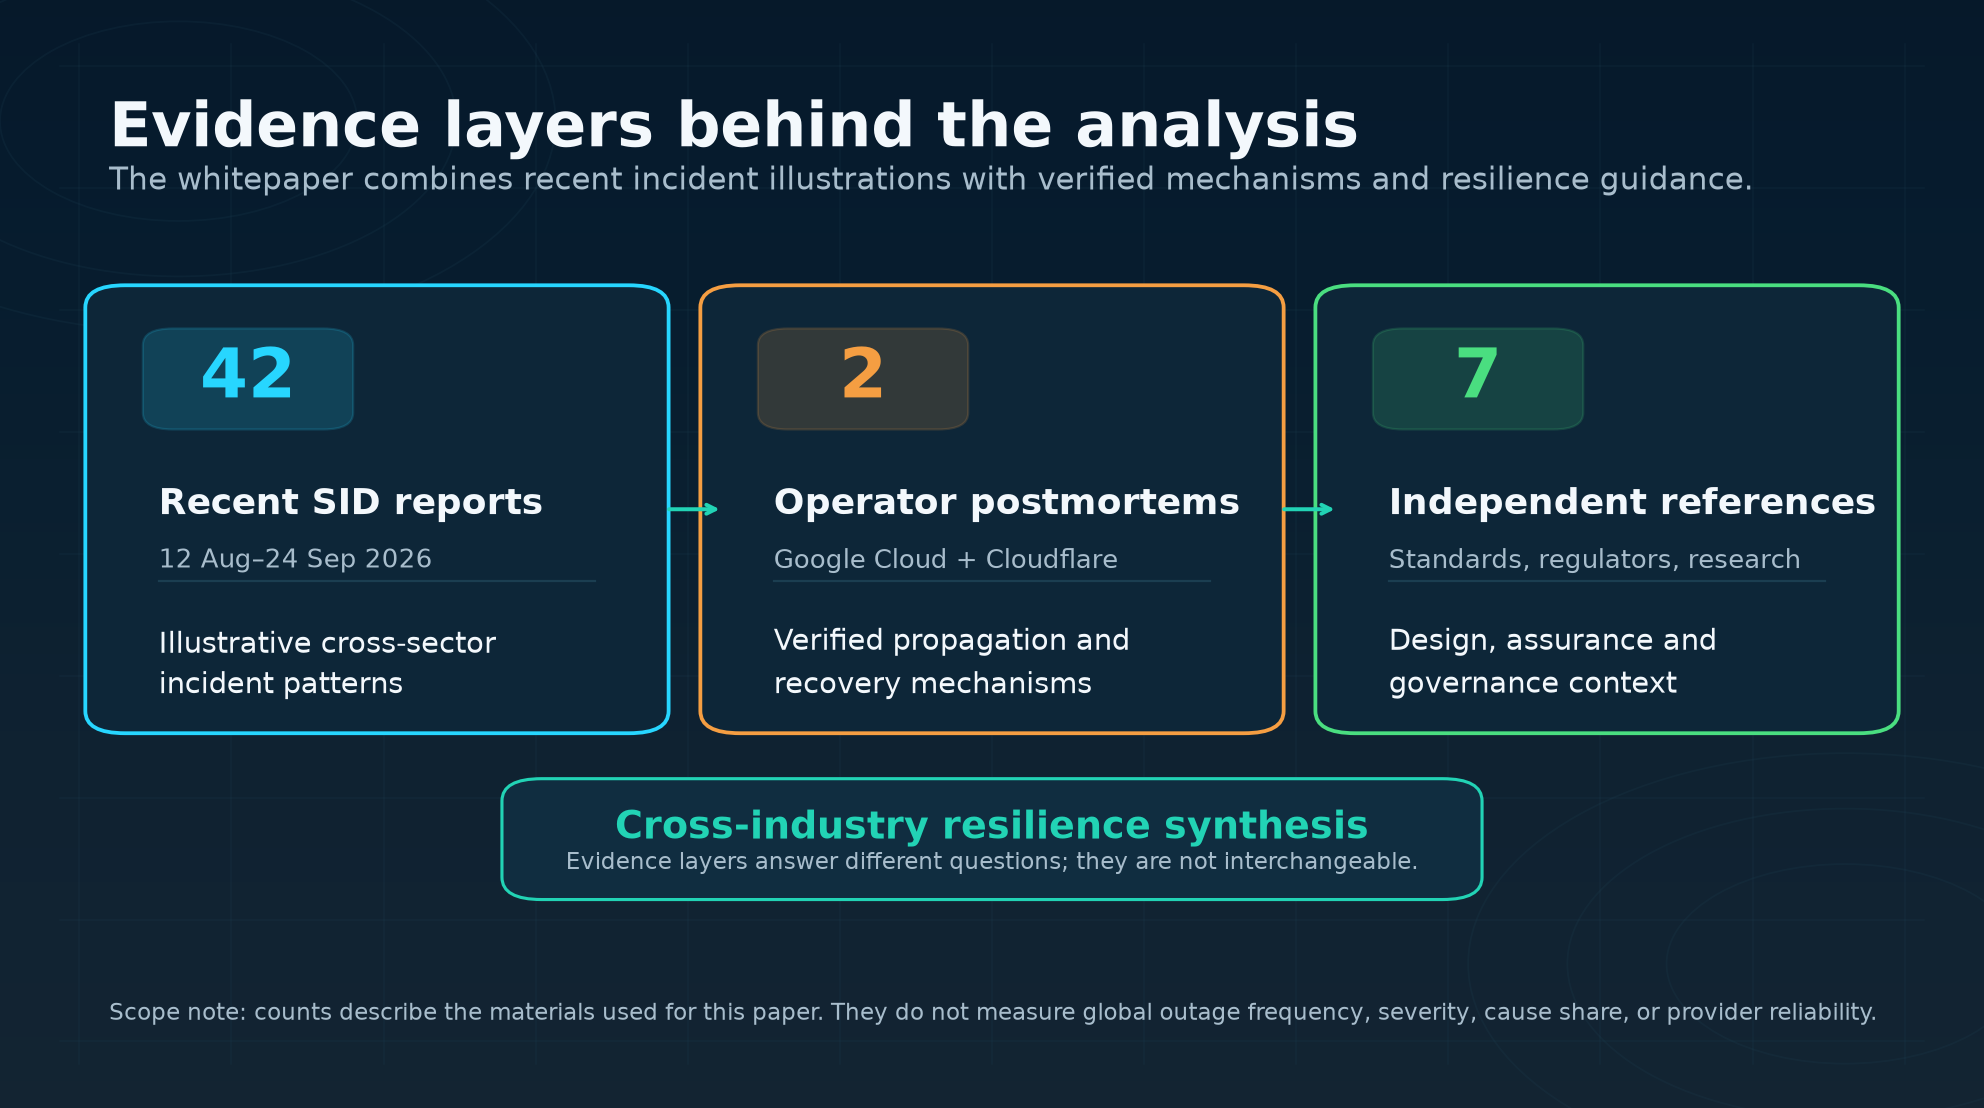
Este documento revisa un corpus editorial de 42 publicaciones de Status Is Down publicadas desde el 12 de agosto hasta el 24 de septiembre de 2026, y luego compara esas ilustraciones con postmortems de operadores y directrices regulatorias o de estándares. El corpus no es un conjunto de datos global de interrupciones estadísticamente representativo, por lo que no puede establecer la frecuencia de incidentes, la fiabilidad comparativa o una causa dominante. Sin embargo, puede exponer preguntas de diseño recurrentes en plataformas en la nube, telecomunicaciones, banca, comunicaciones de emergencia y transporte.
El hallazgo central es que la concentración efectiva de dependencias puede convertir una falla estrecha de control, medio ambiente, enrutamiento, identidad o procesamiento en un incidente de múltiples productos. La degradación elegante puede reducir esa exposición al preservar un servicio mínimo definido, seguro y claramente comunicado. Por lo tanto, la resiliencia debe juzgarse por resultados críticos y normalización verificada, no por el número de proveedores, un solo porcentaje de disponibilidad o el momento en que un proveedor aguas arriba publica "resuelto".
Resumen ejecutivo
La dependencia más importante de una organización no siempre es su proveedor más visible. Puede ser un camino de autenticación compartido, un sistema de distribución de configuraciones, un procesador central, una planta de enfriamiento de centros de datos, un circuito de transportista, una plataforma de estado o un canal de soporte. Estas funciones forman un núcleo de dependencia efectivo: un pequeño conjunto de dominios de falla que pueden interrumpir muchos servicios de marca o viajes de clientes a la vez.
La degradación elegante es el contrapeso práctico. Significa preservar deliberadamente un resultado limitado, seguro y comprensible durante la degradación. No significa aceptar en silencio un servicio inferior, asumiendo que un canal alternativo funciona para cada cliente, o declarar éxito mientras se acumulan colas y trabajos de reconciliación. El modo degradado necesita límites explícitos de capacidad, integridad y comunicación con el cliente, seguidos de un retorno verificado a la operación normal.
| Pregunta de resiliencia | Pruebas que los líderes deben requerir |
|---|---|
| ¿Dónde está concentrada la dependencia? | Un mapa de dominios de falla lógicos, físicos, administrativos y de terceros, no solo una lista de proveedores. |
| ¿Qué sigue siendo seguro de usar? | Un servicio mínimo probado para cada resultado importante del cliente o público, con límites y alternativas establecidos. |
| ¿Cuándo se completa la recuperación? | Pruebas de que los retrasos, la integridad de datos, el servicio regional, los canales de soporte y los flujos de trabajo dependientes se han normalizado. |
Dónde se oculta la concentración
La concentración lógica puede ser tan consecuencia como un cable dañado o una falla en la fuente de alimentación. En el informe de Microsoft 365 y ChatGPT Work, Microsoft atribuyó el impacto continuado a un problema de configuración de autenticación central que afectó a Exchange Online y a los servicios de colaboración y seguridad conectados. El evento de ChatGPT descrito en el mismo artículo fue separado; la proximidad en el tiempo no estableció una causa común. Un informe de múltiples proveedores de IA posterior aplicó la misma salvaguardia: los incidentes de productos concurrentes no eran evidencia de un fallo compartido en la nube.
Dos postmortems de primer nivel muestran cómo la propagación puede amplificar un cambio estrecho. Google Cloud informó que campos en blanco no intencionales en los datos de políticas de cuota se replicaron globalmente en segundos, ejercieron un camino de código de Control de Servicio inadecuadamente protegido y causaron bucles de falla. La mayoría de las regiones comenzaron a recuperarse después de que se deshabilitó la ruta de política, mientras que un efecto de rebaño de reinicio extendió la recuperación en una gran región y algunos productos tenían acumulaciones residuales. Google también dijo que la infraestructura de salud y algunos monitoreos de clientes se vieron afectados.
Cloudflare rastreó por separado su incidente de noviembre de 2025 a un cambio de permiso de base de datos que duplicó un archivo de función de Gestión de Bots. El archivo sobredimensionado se propagó a través de la red y superó un límite de software. Cloudflare descartó explícitamente un ciberataque. El tráfico central fue en gran medida normal a las 14:30 UTC, pero no se informó que todos los sistemas estaban normales hasta las 17:06 UTC. Estos mecanismos no explican los incidentes de 2026; demuestran por qué la generación de configuraciones, validación, implementación, retroceso y observabilidad pertenecen al modelo de fallas de producción.
La concentración física y operativa también puede derrotar a un respaldo nominal. En el incidente de telecomunicaciones del aeropuerto del noreste, un circuito de comunicaciones primario falló mientras una ruta de fibra de respaldo también estaba indisponible tras ser cortada. Las reparaciones permitieron reanudar las operaciones, pero la interrupción de vuelos acumulada permaneció. Una segunda línea en un diagrama no es prueba de resiliencia si comparte un corredor, instalación, plano de control, fuente de alimentación o restricción de reparación con la primera.
El servicio parcial no es lo mismo que la disponibilidad
Los casos de finanzas muestran por qué los resultados del cliente deben evaluarse por separado. Durante una degradación de una aplicación en el Reino Unido, el informe de Monzo describió un acuerdo de banco de respaldo independiente y continuó aceptando pagos con tarjeta, retiros de efectivo, congelación de tarjetas y transferencias mientras algunas funciones de la aplicación estaban limitadas. En el incidente de NAB, se afectaron la banca digital, el comercio y el contacto telefónico, mientras que los cajeros automáticos y los pagos rápidos permanecieron disponibles y se extendió un plazo de Entrada Directa. Ningún ejemplo significa que cada cliente tuvo un sustituto adecuado; muestra que una organización puede diseñar continuidad en torno a tareas específicas en lugar de un solo punto de contacto.
Las dependencias compartidas pueden producir un impacto desigual. El resumen del procesador Mastercard de Status Is Down documentó diferentes estados de procesadores y rutas, sin reclamar un fallo de pago universal o una causa técnica final. El informe de Sharetec describió una interrupción específica de la institución después de que las cooperativas de crédito afectadas atribuyeron el incidente a problemas de enfriamiento y failover en un proveedor compartido de servicios centrales. La restauración central no significó automáticamente que los saldos, la banca digital y cada flujo de trabajo de miembro se reconciliaron al mismo tiempo.
Esa enmarcación orientada a resultados se refleja en CPS 230 de APRA. Para las instituciones australianas reguladas, requiere tolerancias para la máxima interrupción, pérdida de datos y servicio mínimo bajo arreglos alternativos para operaciones críticas. El FFIEC también pide analizar puntos únicos de falla y dependencias en el procesamiento central, la banca en línea y móvil, liquidaciones, servicios públicos y terceros. Estos son requisitos y directrices específicos del sector, no reglas legales universales, pero el principio de diseño se aplica bien: define la tarea que debe continuar antes de seleccionar el respaldo.
Las comunicaciones de emergencia y el transporte exponen el riesgo específico del camino
La comunicación de emergencia no es un solo camino. El informe de Oklahoma 911 distinguió la finalización de llamadas alámbricas de problemas de enrutamiento inalámbrico y describió líneas alternas de diez dígitos y transferencias utilizadas durante la interrupción. No estableció que cada centro de llamadas de Oklahoma fallara simultáneamente, y ninguna fuente revisada suministró un total de llamadas fallidas o una causa raíz más específica. Se necesita cuidado similar siempre que la voz, el texto, los datos de ubicación, el enrutamiento y la entrega de centro de llamadas local tengan diferentes estados.
En los Estados Unidos, la FCC exige a los proveedores cubiertos completar las llamadas al 911, transmitir información de ubicación, abordar la diversidad de circuitos, potencia de respaldo y monitoreo, y notificar a las instalaciones de 911 afectadas sobre interrupciones que pueden afectarles. Esas reglas son específicas de la jurisdicción. Durante cualquier interrupción activa del servicio de emergencia, los lectores deben seguir las instrucciones actuales de la autoridad local relevante en lugar de tratar una página de monitoreo general o de noticias como un sustituto.
Los sistemas de transporte hacen visible la cola de recuperación. Las comunicaciones restauradas pueden reabrir un camino operativo mientras los aviones, las tripulaciones y los pasajeros permanecen fuera de posición. La infraestructura ferroviaria reparada puede permitir el servicio mientras continúan los retrasos residuales. La lección no es que cada incidente de transporte comparte una causa aguas arriba; es que el estado del activo habilitante y el estado del resultado público son hechos operativos diferentes.
La recuperación es una secuencia, no una etiqueta
Un lenguaje de recuperación preciso reduce la falsa tranquilidad y facilita la verificación. Un modelo práctico de cuatro etapas es:
- Contención: la falla está aislada o su propagación se detiene.
- Capacidad mínima restaurada: un resultado crítico definido o un camino alternativo seguro está disponible dentro de sus límites establecidos.
- Normalización en progreso: colas, trabajos demorados, capacidad regional, soporte al cliente, consistencia de datos y flujos de trabajo dependientes están siendo eliminados o verificados.
- Recuperación declarada completa: la integridad y el estado operativo normal se han verificado con criterios de cierre explícitos.
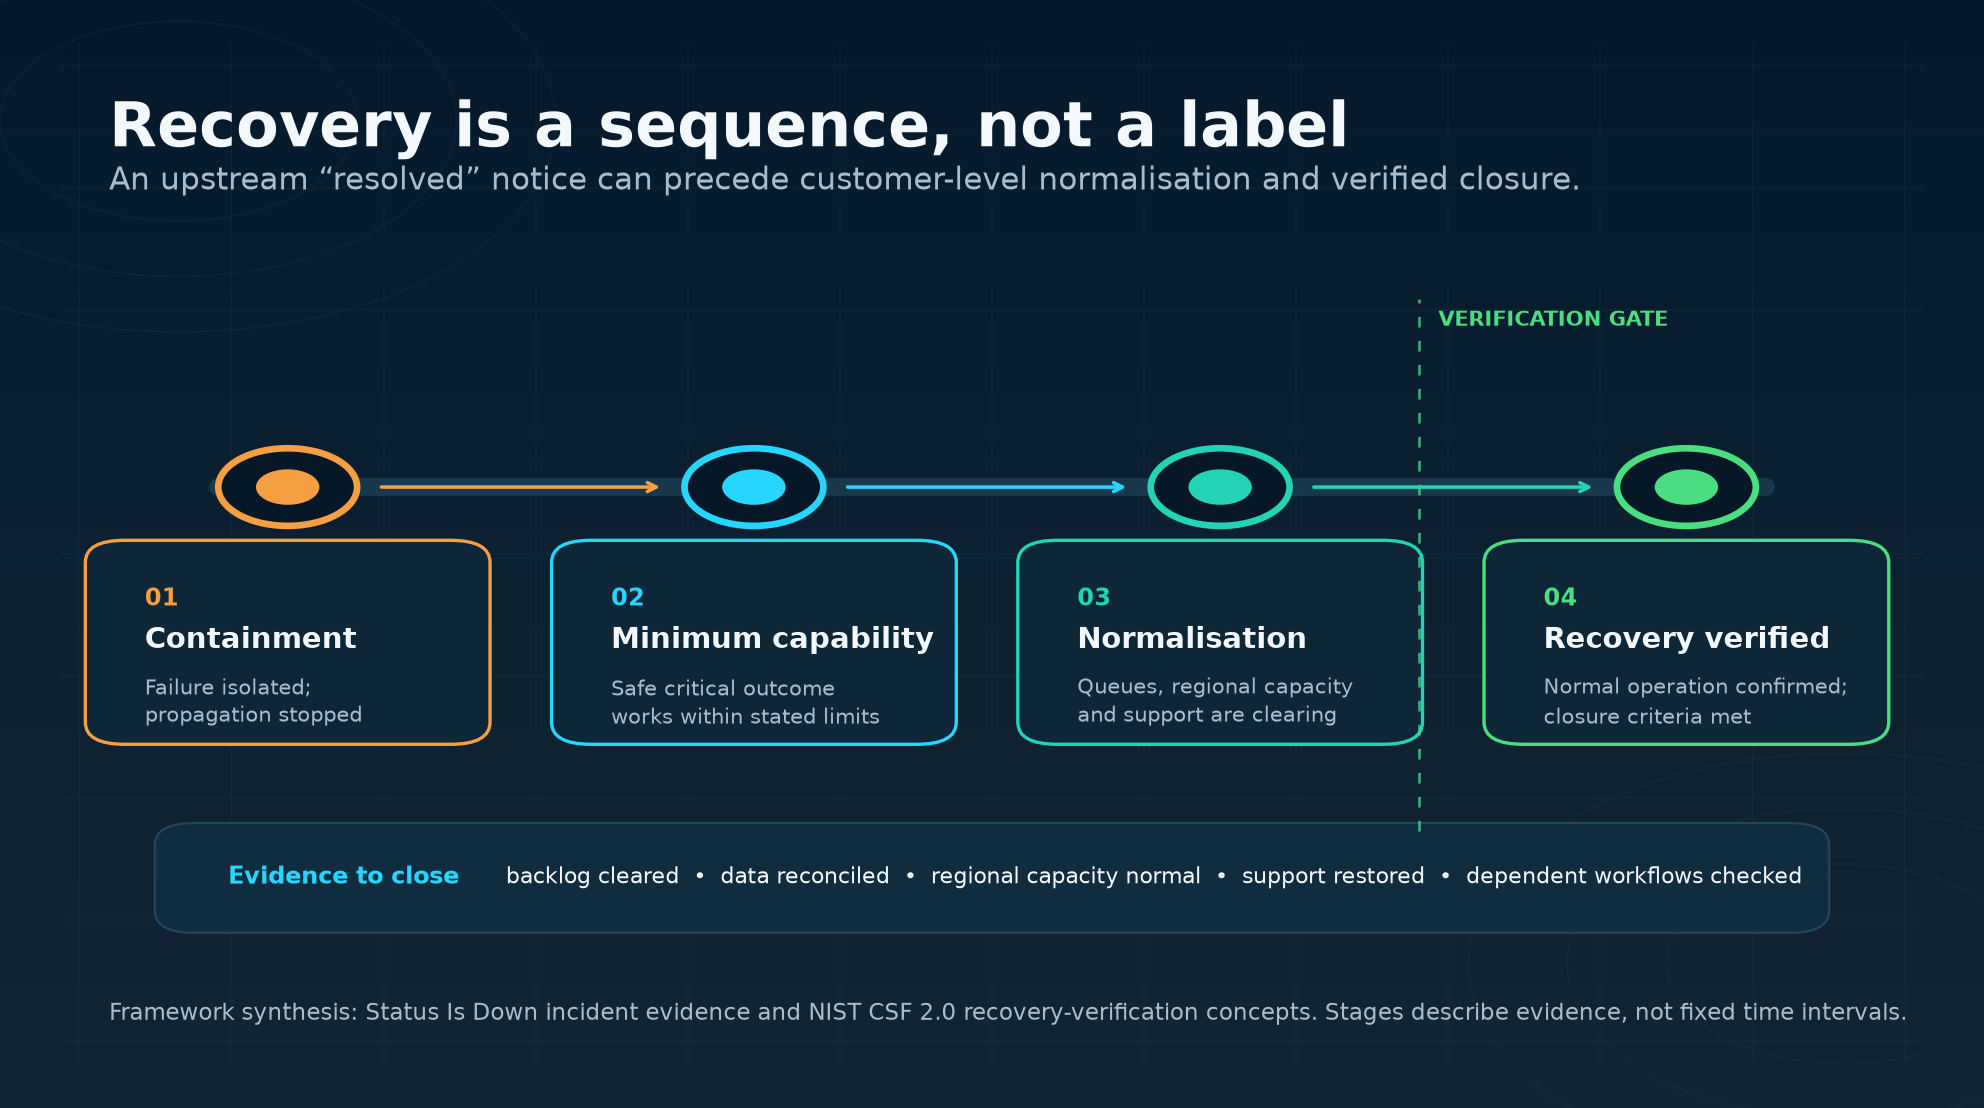
Esta distinción aparece en la evidencia del incidente. J:COM informó sobre la recuperación del servicio listado mientras las llamadas al centro de clientes seguían siendo difíciles. La reparación de telecomunicaciones del aeropuerto permitió reanudar las operaciones antes de que los horarios se normalizaran. Google Cloud y Cloudflare registraron ambos un vacío entre la recuperación general o central y el final de los efectos residuales.
El Marco de Ciberseguridad NIST 2.0 formaliza el paso de verificación para incidentes cibernéticos: las acciones de recuperación se seleccionan y priorizan, se verifican los activos de restauración, se confirma la integridad de los activos restaurados y el estado operativo normal, y se declara el final de la recuperación conforme a criterios. La misma disciplina es útil más allá de la ciberseguridad, incluso cuando el incidente comienza con energía, refrigeración, telecomunicaciones o un error operativo.
Un programa de cinco partes para una degradación elegante
Primero, mapea el resultado importante y cada dominio de falla que lo habilita. Sigue la identidad, DNS, entrega en el borde, planos de control, API, procesadores, centros de datos, transportistas, monitoreo y soporte, incluidos los cuartos y rutas físicas. El marco DORA de la UE trata la concentración crítica de terceros de TIC como una preocupación de resiliencia operativa en finanzas; otros sectores pueden usar el mismo lente analítico sin asumir que la regulación les aplica.
Segundo, define el modo viable mínimo. Establece qué tareas del cliente continúan, qué datos pueden retrasarse, quién recibe prioridad, qué límite de capacidad aplica y cómo se reconciliarán los trabajos retrasados. Una alternativa que es insegura, inaccesible o demasiado pequeña para la demanda no es un servicio degradado creíble.
Tercero, ingeniero la contención y failover. Dependiendo del sistema, los controles pueden incluir implementación por etapas, validación, banderas de función, interruptores de corte, reintentos limitados, retroceso exponencial aleatorizado, interruptores de circuito, colas, cachés, políticas de sesión y soluciones manuales. El postmortem de Google identificó varias de estas como áreas de remediación; el conjunto de controles exactos debe adaptarse al servicio y su riesgo.
Cuarto, preserva la observabilidad y la comunicación independiente. La página de estado, la pila de monitoreo y el canal de soporte pueden compartir la misma dependencia que la producción. Las organizaciones deben identificar una forma separada de observar los resultados del cliente y publicar actualizaciones aprobadas que distingan síntomas, alcance confirmado, estado de causa, soluciones, restauración de capacidad, normalización y cierre.
Quinto, ejercita la falla combinada. La guía de resiliencia operativa de la FCA pide a las empresas del alcance que mapeen personas, procesos, tecnología, instalaciones, información y terceros, y luego prueben escenarios severos pero plausibles. También distingue los objetivos de tiempo de recuperación de las tolerancias de impacto y señala que las acciones de respuesta pueden ganar tiempo mientras se completa la recuperación. Por lo tanto, un ejercicio útil debe probar la pérdida de dependencia, el servicio parcial, la comunicación normal no disponible, la sobrecarga de soporte y la eliminación de acumulaciones juntos, no solo si un servidor de respaldo se inicia.
Medidas que las juntas pueden utilizar
Un solo porcentaje de disponibilidad no puede mostrar si un cliente completó un pago, alcanzó los servicios de emergencia, registró un vuelo o accedió a una función crítica de la cuenta. Las medidas orientadas a resultados pueden incluir el tiempo de detección, el tiempo hasta la primera contingencia usable, el porcentaje o volumen de tareas críticas completadas de manera segura, la antigüedad de las colas, las excepciones de reconciliación, la disponibilidad del canal de soporte, el tiempo hasta las operaciones normales verificadas y los riesgos de recuperación no resueltos.
El análisis de 2026 del Instituto de Uptime proporciona un contexto más amplio: informa que la frecuencia de interrupciones por sitio disminuyó por quinto año, mientras que las fallas en la infraestructura externa se volvieron más prominentes en las interrupciones reportadas públicamente y los incidentes de fibra y conectividad eran más propensos a producir interrupciones prolongadas. Su evidencia combina encuestas, informes públicos, miembros, socios y su propia base de datos. Esos hallazgos no deben ser tratados como un censo del corpus de Status Is Down, pero refuerzan la necesidad de mirar más allá del equipo interno y mapear las dependencias externas.
Lo que esto significa para los usuarios de Status Is Down
Status Is Down puede apoyar ese trabajo ayudando a los equipos a comparar las señales actuales de los usuarios con las actualizaciones de los operadores a través de sus registros de sitios web, directorio de servicios y tablero en tiempo real. Estos recursos complementan, en lugar de reemplazar, instrucciones oficiales de proveedores, de emergencia o de transporte.
Crear una cuenta y seleccionar un plan de monitoreo puede ayudar a los equipos a seguir los servicios externos de los que dependen y añadir contexto a su propia telemetría. La tarea de resiliencia más amplia sigue siendo organizacional: definir el resultado crítico, probar el modo degradado y verificar el camino de regreso a lo normal. Los lectores también pueden explorar investigaciones adicionales en la colección de Documentos Blancos de la Industria.
Metodología y límites
El material de Status Is Down utilizado aquí es un corpus seleccionado editorialmente, vinculado a fuentes, no un estudio de prevalencia. Los conteos de artículos no pueden respaldar afirmaciones sobre frecuencia, gravedad, geografía, duración, fiabilidad comparativa o participación de causa raíz. Informes contemporáneos también pueden ser revisados por análisis posteriores de operadores. Por lo tanto, el lenguaje de causa sigue siendo limitado: confirmado donde existe un postmortem, atribuido donde un operador o institución proporcionó un relato, y no revelado donde la evidencia no estableció más.
La concurrencia no es causalidad. Síntomas similares o sincronización superpuesta no prueban un fallo compartido en la nube, transportista, ciberataque, evento de sabotaje o falla del proveedor. La disponibilidad parcial tampoco es prueba de inofensividad: un cajero automático, ruta de tarjeta, número alternativo o canal de texto pueden tener elegibilidad, capacidad, accesibilidad o límites geográficos. Finalmente, las fuentes regulatorias en este documento describen sus propios sectores y jurisdicciones y no deben leerse como asesoría legal.
Conclusión
Un servicio resiliente no promete que cada componente permanecerá disponible para siempre. Hace visibles los límites de la dependencia, limita el radio de explosión, preserva resultados críticos definidos donde sea seguro, comunica lo que los usuarios pueden y no pueden hacer, y declara la recuperación completa solo después de la verificación. Para los líderes que revisan las tendencias recientes de interrupciones, la degradación elegante no es una versión más suave de la disponibilidad; es la disciplina operativa que convierte las dependencias concentradas en riesgo medible y limitado.
Fuentes
- Status Is Down: La interrupción de Microsoft 365 deja a un pequeño subconjunto afectado en el tercer día; ChatGPT Work se recupera tras cinco horas de interrupción
- Status Is Down: Las interrupciones de ChatGPT y Claude afectan a los usuarios de IA a medida que los informes se difunden a través de Gemini, Copilot y Grok
- Status Is Down: Cuba comienza la recuperación de la red después de un apagón nacional; La interrupción de Sharetec afecta a las cooperativas de crédito
- Status Is Down: J:COM restaura la banda ancha tras una amplia interrupción en Japón; NAB resuelve la interrupción de la banca digital
- Status Is Down: Operaciones del aeropuerto del noreste se reanudan después de una interrupción de telecomunicaciones; La recuperación de la utilidad del estado de Michigan continúa
- Status Is Down: Los pagos de Mastercard fallan a nivel mundial: cinco procesadores informan errores antes de que comience la recuperación
- Status Is Down: Monzo activa un banco de respaldo en medio de una interrupción de aplicación en el Reino Unido; Un fallo de reserva de IndiGo bloquea las reservas en India
- Status Is Down: Oklahoma restaura el enrutamiento del 911 después de un problema de red; postes caídos interrumpen el servicio ferroviario de Long Island
- Google Cloud: Múltiples productos de GCP están experimentando problemas de Servicio
- Cloudflare: Interrupción de Cloudflare el 18 de noviembre de 2025
- Instituto de Uptime: Informe de Análisis de Interrupciones Anual 2026
- Instituto Nacional de Estándares y Tecnología: El Marco de Ciberseguridad NIST (CSF) 2.0
- Autoridad de Conducta Financiera: Resiliencia operativa: ideas y observaciones para las empresas
- Comisión Federal de Comunicaciones: Fiabilidad del 911
- Autoridad Reguladora Prudencial de Australia: Estándar Prudencial CPS 230 Gestión de Riesgos Operacionales
- Autoridad Europea de Seguros y Pensiones Profesionales: Ley de Resiliencia Operativa Digital (DORA)
- Consejo de Examinación de Instituciones Financieras Federales: Gestión de Continuidad del Negocio: Análisis de Interdependencia
Crédito de imagen: Ilustración generada para Status Is Down