Quando 'Down' non è 'Scomparso': Progettare una Degradazione Elegante per Dipendenze Digitali Concentrate
Gran parte dei report sulle interruzioni inizia con una domanda binaria: il servizio è attivo o non attivo? Incidenti recenti trasversali a diversi settori indicano una domanda più utile per i leader della tecnologia, del rischio e delle operazioni: quali risultati per i clienti funzionano ancora quando una dipendenza condivisa fallisce, e come farà l'organizzazione a sapere quando il recupero è genuinamente completo?
Questo whitepaper esamina un corpus editoriale di 42 articoli pubblicati su Status Is Down dal 12 agosto al 24 settembre 2026, e poi confronta quelle illustrazioni con le post-mortem degli operatori e linee guida regolatorie o normative. Il corpus non è un dataset globale di interruzione statisticamente rappresentativo, quindi non può stabilire la frequenza degli incidenti, l'affidabilità comparativa o una causa dominante. Tuttavia, può mettere in evidenza domande di design ricorrenti attraverso piattaforme cloud, telecomunicazioni, banche, comunicazioni di emergenza e trasporti.
Il risultato centrale è che una concentrazione efficace delle dipendenze può trasformare una fallimento ristretto di controllo, ambiente, instradamento, identità o elaborazione in un incidente multifunzionale. La degradazione elegante può ridurre quell'esposizione preservando un servizio minimo definito, sicuro e chiaramente comunicato. La resilienza dovrebbe quindi essere giudicata in base ai risultati critici e a una normalizzazione verificata—non da un conteggio dei fornitori, da una singola percentuale di disponibilità o dal momento in cui un fornitore upstream pubblica "risolto."
Sommario esecutivo
La dipendenza più importante di un'organizzazione non è sempre il suo fornitore più visibile. Potrebbe essere un percorso di autenticazione condiviso, un sistema di distribuzione della configurazione, un processore centrale, un impianto di raffreddamento del data center, un circuito di carrier, una piattaforma di stato o un canale di supporto. Queste funzioni formano un nucleo di dipendenza efficace: un piccolo insieme di domini di fallimento che possono interrompere molti servizi di marca o percorsi clienti contemporaneamente.
La degradazione elegante è il contrappeso pratico. Significa preservare deliberatamente un risultato limitato, sicuro e comprensibile durante un'interferenza. Non significa accettare silenziosamente un servizio inferiore, presumendo che un canale alternativo funzioni per ogni cliente, o dichiarare il successo mentre si accumulano code e lavori di riconciliazione. La modalità degradata ha bisogno di confini espliciti di capacità, integrità e comunicazione con il cliente, seguiti da un ritorno verificato alla normale operatività.
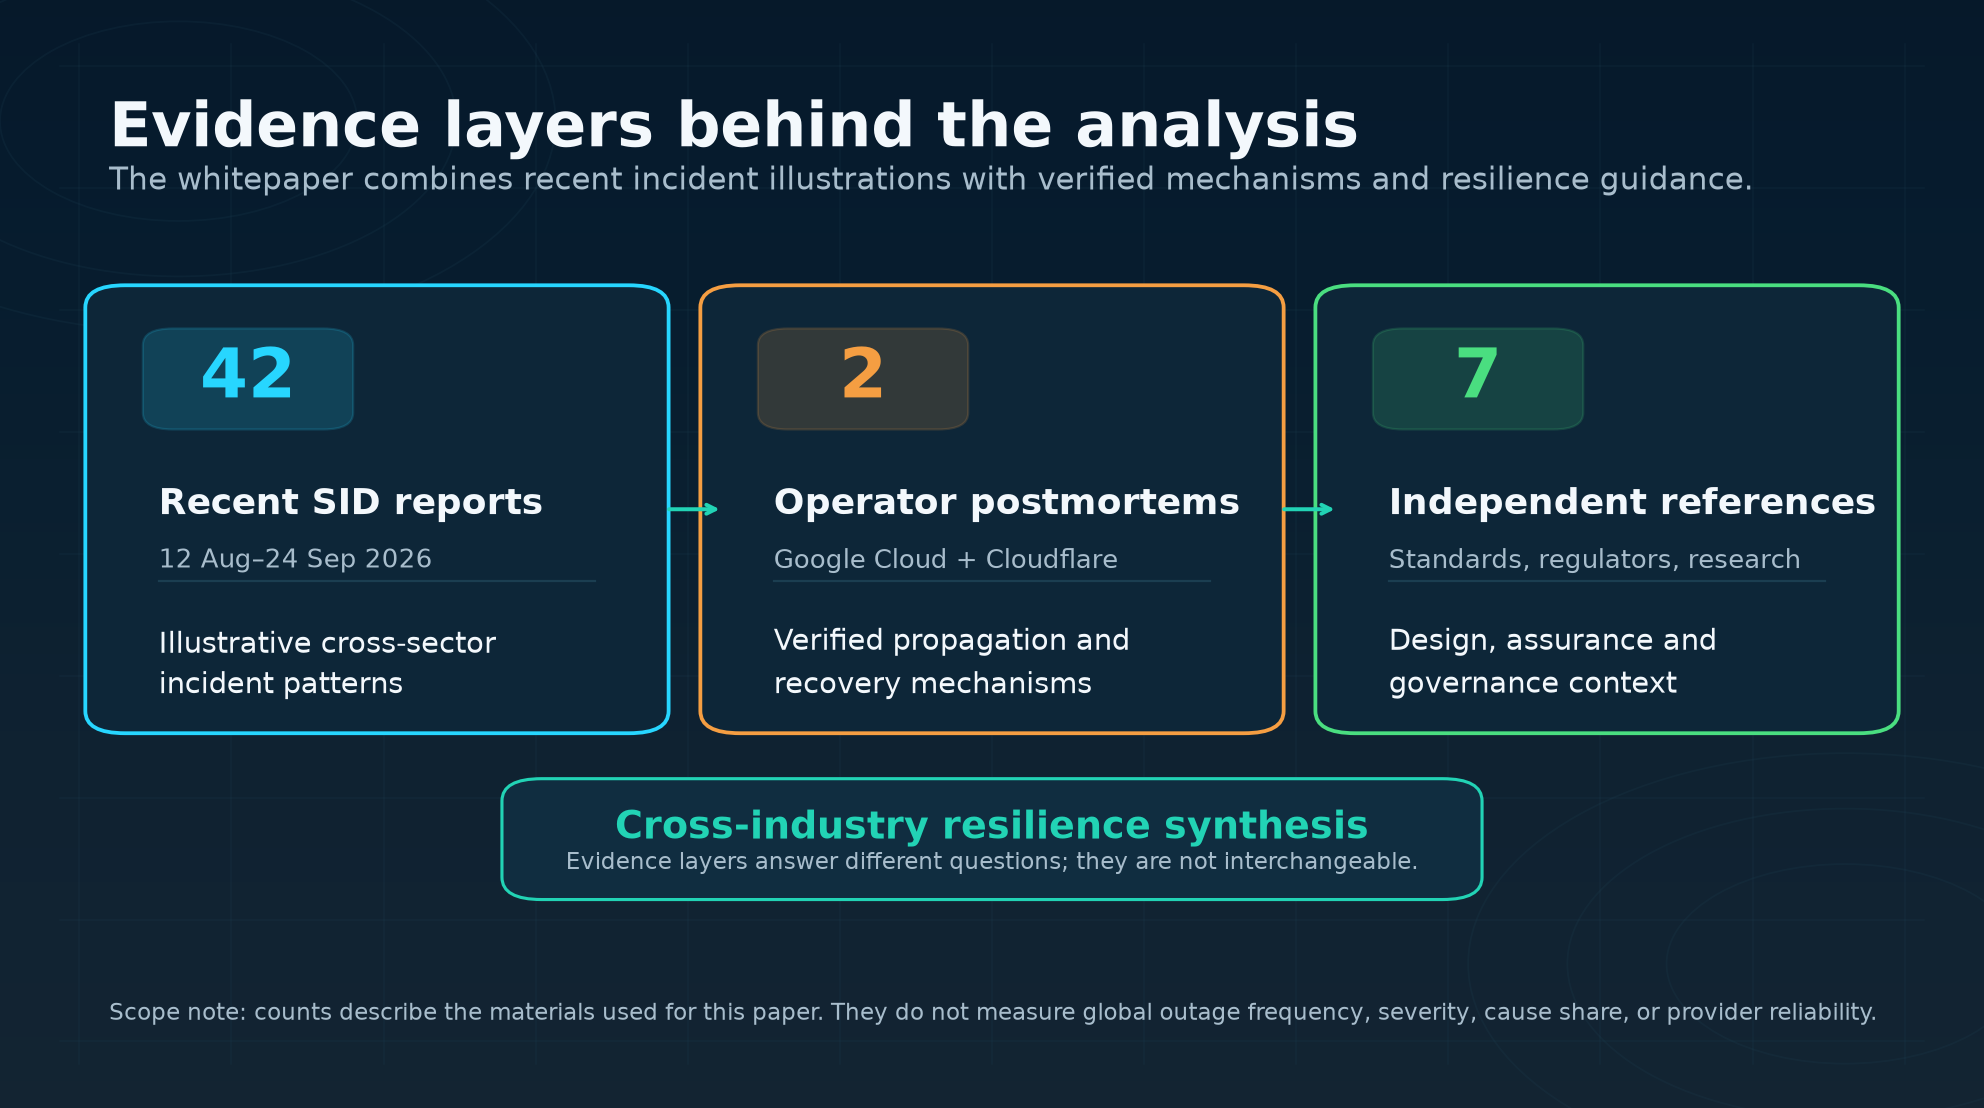
Dove si nasconde la concentrazione
La concentrazione logica può essere tanto consequenziale quanto un cavo danneggiato o un'alimentazione elettrica guasta. Nel rapporto su Microsoft 365 e ChatGPT Work di Status Is Down, Microsoft ha attribuito l'impatto continuato a un problema di configurazione dell'autenticazione centrale che ha raggiunto Exchange Online e i servizi di collaborazione e sicurezza connessi. L'evento ChatGPT descritto nello stesso articolo era separato; la vicinanza temporale non ha stabilito una causa comune. Un rapporto multi-fornitore AI successivo ha applicato la stessa salvaguardia: gli incidenti di prodotto simultanei non erano evidenza di un singolo fallimento condiviso nel cloud.
Due post-mortem di primo livello mostrano come la propagazione possa amplificare un cambiamento ristretto. Google Cloud ha riportato che campi vuoti non intenzionali nei dati sulla politica di quota si sono replicati globalmente in pochi secondi, hanno esercitato un percorso di codice di controllo servizio insufficientemente protetto e hanno causato cicli di crash. La maggior parte delle regioni ha iniziato a recuperare dopo che il percorso di policy è stato disabilitato, mentre un effetto di ripristino a branco ha esteso il recupero in una grande regione e alcuni prodotti avevano arretrati residui. Google ha anche dichiarato che le infrastrutture di monitoraggio della salute e dei clienti erano compromesse.
Cloudflare ha tracciato separatamente il suo incidente di novembre 2025 a un cambiamento delle autorizzazioni del database che ha raddoppiato un file della funzionalità di gestione dei bot. Il file sovradimensionato si è propagato attraverso la rete e ha superato un limite software. Cloudflare ha esplicitamente escluso un attacco informatico. Il traffico principale era in gran parte normale entro le 14:30 UTC, ma tutti i sistemi non sono stati dichiarati normali fino alle 17:06 UTC. Questi meccanismi non spiegano gli incidenti del 2026; dimostrano perché la generazione di configurazioni, la validazione, il roll-out, il rollback e l'osservabilità appartengono all'interno del modello di fallimento della produzione.
La concentrazione fisica e operativa può anche compromettere un backup nominale. Nell'incidente delle telecomunicazioni dell'aeroporto del Nordest, un circuito di comunicazione primario è fallito mentre un percorso in fibra di backup era anch'esso non disponibile dopo essere stato interrotto. Le riparazioni hanno permesso alle operazioni di riprendere, ma il disagio accumulato dei voli è rimasto. Una seconda linea in un diagramma non è prova di resilienza se condivide un corridoio, una struttura, un piano di controllo, una fonte di alimentazione o un vincolo di riparazione con la prima.
Un servizio parziale non è lo stesso che disponibilità
I casi finanziari mostrano perché dovrebbero essere valutati separatamente i risultati per i clienti. Durante un'interferenza dell'app nel Regno Unito, il rapporto Monzo ha descritto un accordo con una banca di backup indipendente e pagamenti con carta, prelievi, congelamenti di carte e trasferimenti continuati mentre alcune funzioni dell'app erano limitate. Nell'incidente NAB, la banca digitale, il trading e il contatto telefonico sono stati colpiti, mentre gli sportelli automatici e i pagamenti rapidi sono rimasti disponibili e una scadenza per il metodo Direct Entry è stata prorogata. Nessuno dei due esempi significa che ogni cliente avesse un sostituto adeguato; dimostra che un'organizzazione può progettare continuità attorno a compiti specifici piuttosto che a un'unica interfaccia.
Le dipendenze condivise possono produrre un impatto irregolare. Il riassunto dei processori Mastercard di Status Is Down ha documentato stati diversi di processori e percorsi, senza dichiarare un fallimento universale dei pagamenti o una causa tecnica finale. Il rapporto Sharetec ha descritto un'interruzione specifica per istituzioni dopo che le credit unions colpite hanno attribuito l'incidente a problemi di raffreddamento e failover presso un fornitore di servizi core condivisi. Il ripristino del core non significava automaticamente che i saldi, la banca digitale e ogni flusso di lavoro del membro fossero stati riconciliati contemporaneamente.
Quella definizione guida basata sui risultati è riflessa nelle CPS 230 di APRA. Per le istituzioni australiane regolamentate, richiede tolleranze per la massima interruzione, la perdita di dati e il servizio minimo in alternativa per operazioni critiche. Il FFIEC richiede anch'esso l'analisi dei punti di fallimento e delle dipendenze attraverso il processamento core, la banca online e mobile, il regolamento, le utility e i terzi. Questi sono requisiti e linee guida specifiche per settore, non regole legali universali, ma il principio del design si applica bene: definire il compito che deve continuare prima di selezionare il backup.
Le comunicazioni di emergenza e i trasporti espongono i rischi specifici del percorso
La comunicazione di emergenza non è un solo percorso. Il rapporto Oklahoma 911 ha distinto il completamento delle chiamate via cavo dai problemi di instradamento wireless e ha descritto linee alternative a dieci cifre e trasferimenti utilizzati durante l'interruzione. Non ha stabilito che ogni call center dell'Oklahoma sia fallito simultaneamente, e nessuna fonte esaminata ha fornito un totale delle chiamate fallite o una causa principale più specifica. La stessa cautela è necessaria ogni volta che voce, testo, dati sulla posizione, instradamento e consegna del call center locale hanno stati diversi.
I sistemi di trasporto rendono visibile la coda di recupero. Le comunicazioni ripristinate possono riaprire un percorso operativo mentre aerei, equipaggi e passeggeri rimangono fuori posizione. Le infrastrutture ferroviarie riparate possono consentire il servizio mentre continuano i ritardi residui. La lezione non è che ogni incidente di trasporto condivide una causa upstream; è che lo stato dell'asset abilitante e lo stato dell'esito pubblico sono fatti operativi diversi.
Il recupero è una sequenza, non un'etichetta
Un linguaggio di recupero preciso riduce la falsa rassicurazione e rende più facile la verifica. Un modello pratico in quattro fasi è:
- Contenimento: il fallimento è isolato o la sua propagazione è fermata.
- Capacità minima ripristinata: un risultato critico definito o un percorso alternativo sicuro è disponibile entro i suoi limiti dichiarati.
- Normalizzazione in corso: code, lavori in ritardo, capacità regionale, supporto clienti, coerenza dei dati e flussi di lavoro dipendenti sono in fase di eliminazione o controllo.
- Recupero dichiarato completo: l'integrità e lo stato operativo normale sono stati verificati in base a criteri di chiusura espliciti.
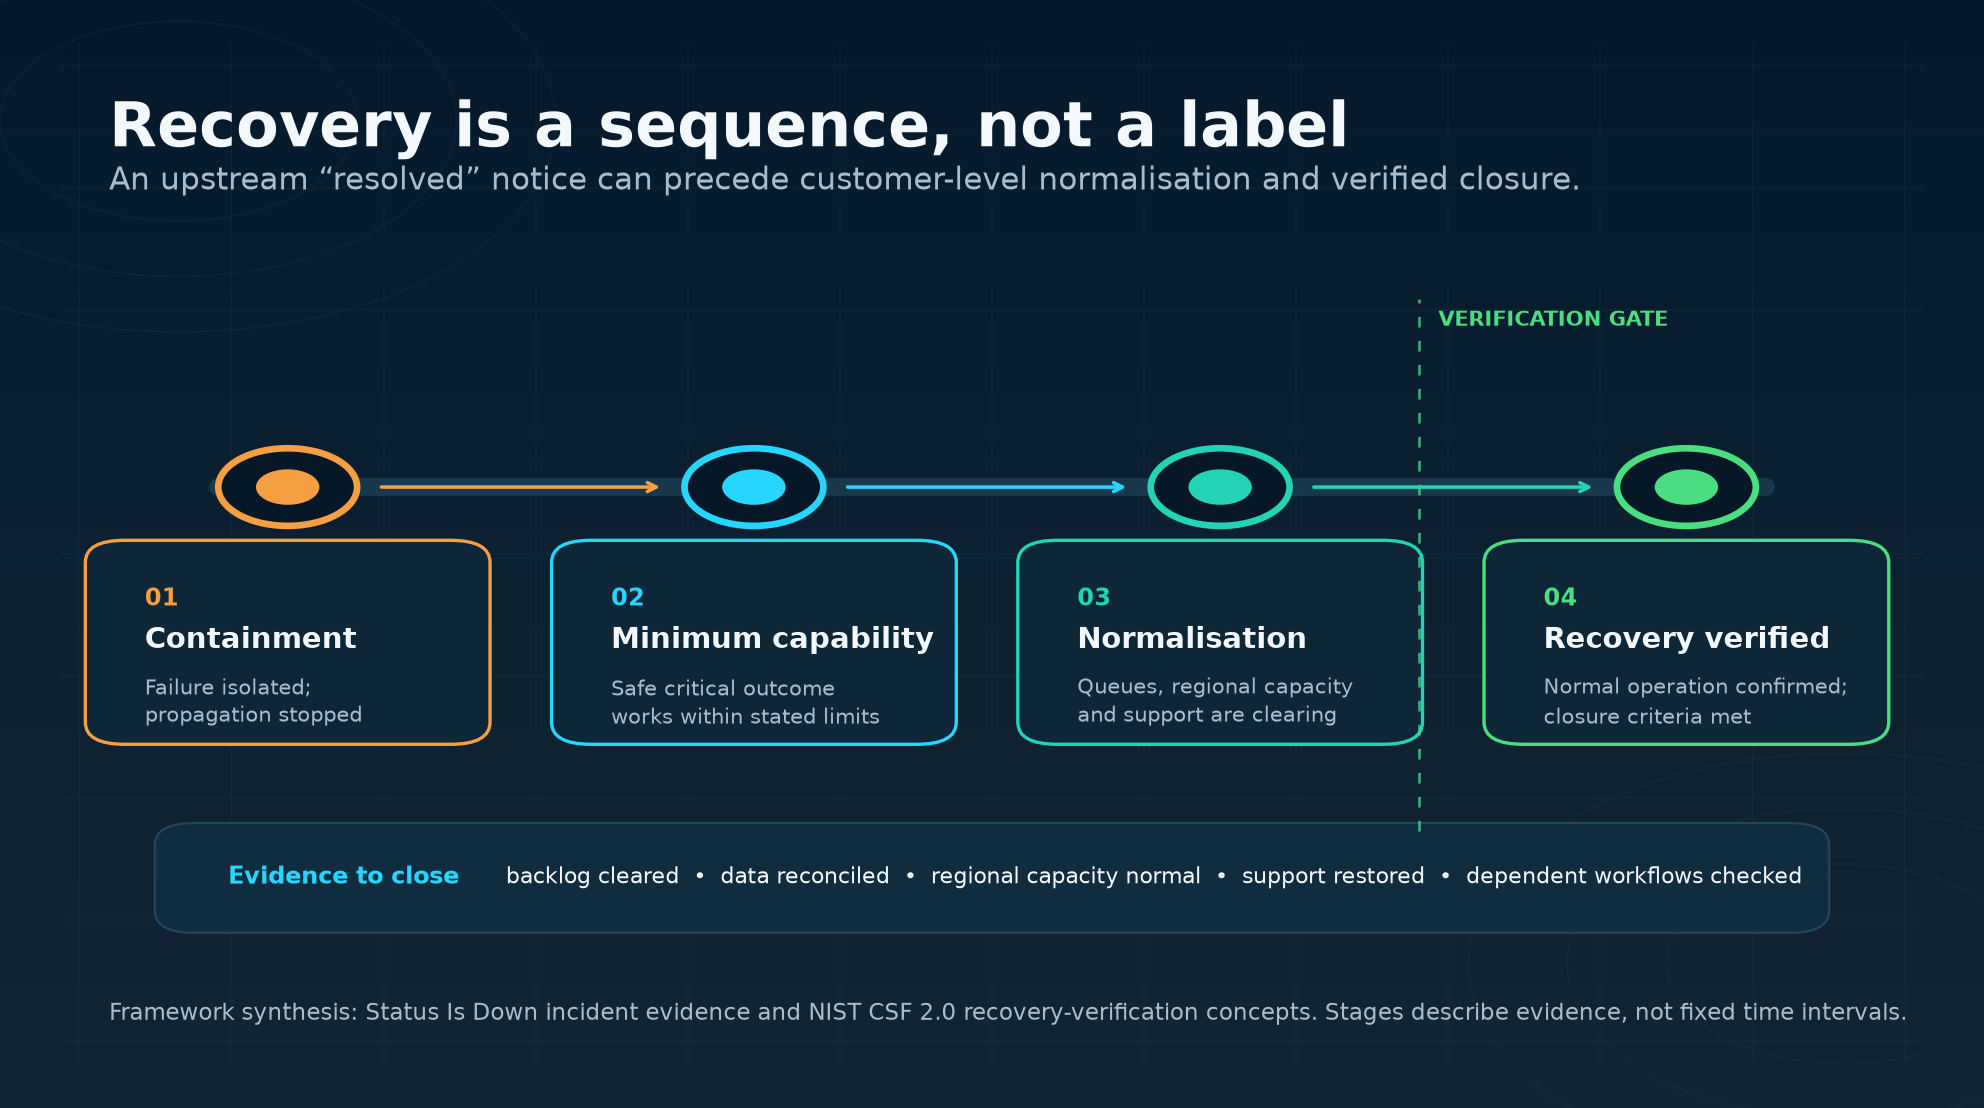
Questa distinzione appare nelle prove degli incidenti. J:COM ha riportato un recupero dei servizi elencati mentre le chiamate al centro clienti rimanevano difficili. La riparazione delle telecomunicazioni dell'aeroporto ha consentito alle operazioni di riprendere prima che gli orari si normalizzassero. Google Cloud e Cloudflare hanno entrambi registrato un divario tra il recupero generale o core e la fine degli effetti residui.
Il NIST Cybersecurity Framework 2.0 formalizza il passo di verifica per gli incidenti informatici: le azioni di recupero sono selezionate e priorizzate, gli asset di ripristino sono controllati, l'integrità degli asset ripristinati e lo stato operativo normale sono confermati e la fine del recupero è dichiarata in base ai criteri. La stessa disciplina è utile oltre la sicurezza informatica, anche quando l'incidente inizia con alimentazione, raffreddamento, telecomunicazioni o un errore operativo.
Un programma in cinque parti per una degradazione elegante
Prima di tutto, mappa l'esito importante e ogni dominio di fallimento che lo abilita. Segui identità, DNS, consegna edge, piani di controllo, API, processori, data center, carrier, monitoraggio e supporto, inclusi i quarti fornitori e i percorsi fisici. Il framework DORA della UE tratta la concentrazione critica delle terze parti ICT come una preoccupazione di resilienza operativa nella finanza; altri settori possono utilizzare la stessa lente analitica senza presumere che la regolamentazione si applichi a loro.
Secondo, definisci la modalità minima praticabile. Indica quali compiti dei clienti continuano, quali dati possono essere ritardati, chi riceve priorità, quale limite di capacità si applica e come il lavoro deferito sarà riconciliato. Un'alternativa che non è sicura, inaccessibile o troppo piccola per la domanda non è un servizio degradato credibile.
Terzo, ingegnerizza contenimento e failover. A seconda del sistema, i controlli possono includere il rollout a fasi, la validazione, i flag delle funzionalità, gli interruttori di spegnimento, i tentativi limitati, il backoff esponenziale randomizzato, i circuit breaker, le code, le cache, le policy di sessione e le soluzioni manuali. Il post-mortem di Google ha identificato diversi di questi come aree di rimedi; il set di controlli esatti deve adattarsi al servizio e al suo rischio.
Quarto, preserva l'osservabilità e la comunicazione indipendente. La pagina di stato, lo stack di monitoraggio e il canale di supporto possono condividere la stessa dipendenza della produzione. Le organizzazioni dovrebbero identificare un modo separato per osservare i risultati dei clienti e pubblicare aggiornamenti approvati che distinguano i sintomi, l'ambito confermato, lo stato della causa, le soluzioni, il ripristino delle capacità, la normalizzazione e la chiusura.
Quinto, esercita il fallimento combinato. La linea guida sulla resilienza operativa della FCA chiede alle aziende in ambito di mappare persone, processi, tecnologia, strutture, informazioni e terzi, e poi testare scenari gravi ma plausibili. Essa distingue anche gli obiettivi di tempo di recupero dalle tolleranze all'impatto e nota che le azioni di risposta possono guadagnare tempo mentre il recupero si completa. Un esercizio utile dovrebbe quindi testare insieme la perdita della dipendenza, il servizio parziale, le comunicazioni normali non disponibili, il sovraccarico del supporto e la pulizia degli arretrati—non solo se un server di backup si avvia.
Misure che i consigli possono utilizzare
Una singola percentuale di disponibilità non può mostrare se un cliente ha completato un pagamento, ha contattato i servizi di emergenza, si è registrato per un volo o ha accesso a una funzione critica dell'account. Le misure orientate ai risultati possono includere il tempo di rilevamento, il tempo fino alla prima contingenza utilizzabile, la percentuale o il volume dei compiti critici completati in sicurezza, l'età della coda, le eccezioni di riconciliazione, la disponibilità del canale di supporto, il tempo di verificata operatività normale e i rischi di recupero non risolti.
L'analisi 2026 dell'Uptime Institute fornisce un contesto più ampio: riporta che la frequenza delle interruzioni per sito è diminuita per il quinto anno, mentre i fallimenti delle infrastrutture esterne sono diventati più prominenti nelle interruzioni segnalate pubblicamente e gli incidenti di fibra e connettività erano più propensi a produrre interruzioni prolungate. Le sue prove combinano sondaggi, rapporti pubblici, membri, partner e il suo stesso database. Questi risultati non dovrebbero essere trattati come un censimento del corpus di Status Is Down, ma rafforzano la necessità di guardare oltre l'attrezzatura interna e mappare le dipendenze esterne.
Cosa significa per gli utenti di Status Is Down
Status Is Down può supportare quel lavoro aiutando i team a confrontare i segnali degli utenti attuali con gli aggiornamenti degli operatori attraverso i suoi registri del sito web, direttorio dei servizi e dashboard in tempo reale. Queste risorse integrano, piuttosto che sostituire, le istruzioni ufficiali dei fornitori, di emergenza o di trasporto.
Creare un account e selezionare un piano di monitoraggio può aiutare i team a seguire i servizi esterni di cui dipendono e aggiungere contesto alla propria telemetria. Il compito di resilienza più ampio rimane organizzativo: definire il risultato critico, testare la modalità degradata e verificare il percorso di ritorno alla normalità. I lettori possono anche esplorare ulteriori ricerche nella collezione Whitepapers di settore.
Metodologia e limiti
Il materiale di Status Is Down utilizzato qui è un corpus selezionato editorialmente e con link a fonti, non uno studio di prevalenza. I conteggi degli articoli non possono supportare affermazioni sulla frequenza, gravità, geografia, durata, affidabilità comparativa o condivisione della causa principale. I rapporti contemporanei possono anche essere rivisti da analisi successive degli operatori. Il linguaggio di causa rimane quindi ristretto: confermato dove esiste un post-mortem, attribuito dove un operatore o un'istituzione ha fornito un resoconto, e non divulgato dove le prove non hanno stabilito di più.
La concorrenza non è causalità. Sintomi simili o una tempistica sovrapposta non provano un fallimento condiviso del cloud, del carrier, un attacco informatico, un sabota evento o un fallimento del fornitore. La disponibilità parziale non è nemmeno la prova di innocuità: un bancomat, un percorso della carta, un numero alternativo o un canale di testo possono avere limiti di idoneità, capacità, accessibilità o geografici. Infine, le fonti regolamentari in questo documento descrivono i propri settori e giurisdizioni e non dovrebbero essere lette come consulenza legale.
Conclusione
Un servizio resiliente non promette che ogni componente rimarrà disponibile per sempre. Rende visibili i confini della dipendenza, limita il raggio d'esplosione, preserva risultati critici definiti dove sicuro, comunica ciò che gli utenti possono e non possono fare e dichiara il recupero completato solo dopo verifica. Per i leader che esaminano le tendenze recenti delle interruzioni, la degradazione elegante non è una versione più morbida dell'uptime; è la disciplina operativa che trasforma le dipendenze concentrate in rischi misurabili e delimitati.
Fonti
- Status Is Down: L'interruzione di Microsoft 365 lascia un piccolo sottoinsieme colpito per il terzo giorno; ChatGPT Work si riprende dopo cinque ore di interruzione
- Status Is Down: Le interruzioni di ChatGPT e Claude colpiscono gli utenti IA mentre i rapporti si diffondono attraverso Gemini, Copilot e Grok
- Status Is Down: Cuba inizia il recupero della rete dopo un blackout nazionale; L'interruzione di Sharetec interrompe le credit unions
- Status Is Down: J:COM ripristina la banda larga dopo un'ampia interruzione in Giappone; NAB risolve l'interruzione della banca digitale
- Status Is Down: Le operazioni dell'aeroporto del Nordest riprendono dopo l'interruzione delle telecomunicazioni; Il recupero dell'utility del Michigan continua
- Status Is Down: I pagamenti Mastercard falliscono a livello mondiale: cinque processori segnalano errori prima che inizi il recupero
- Status Is Down: Monzo attiva la banca di backup durante un'interruzione dell'app nel Regno Unito; Il glitch di prenotazione di IndiGo blocca le prenotazioni in India
- Status Is Down: L'Oklahoma ripristina l'instradamento 911 dopo un problema nella rete; i poli abbattuti interrompono il servizio ferroviario di Long Island
- Google Cloud: Molti prodotti GCP stanno vivendo problemi di servizio
- Cloudflare: Interruzione di Cloudflare il 18 novembre 2025
- Uptime Institute: Rapporto annuale di analisi delle interruzioni 2026
- National Institute of Standards and Technology: Il NIST Cybersecurity Framework (CSF) 2.0
- Financial Conduct Authority: Resilienza operativa: conoscenze e osservazioni per le aziende
- Federal Communications Commission: Affidabilità 911
- Australian Prudential Regulation Authority: Standard Prudenziali CPS 230 Gestione del Rischio Operativo
- European Insurance and Occupational Pensions Authority: Digital Operational Resilience Act (DORA)
- Federal Financial Institutions Examination Council: Business Continuity Management: Analisi di Interdipendenza
Credito immagine: Illustrazione generata per Status Is Down