Quando ‘Indisponível’ Não É ‘Ausente’: Projetando Degradação Elegante para Dependências Digitais Concentradas
A maioria dos relatórios de interrupção começa com uma pergunta binária: o serviço está funcionando ou está fora do ar? Incidentes recentes em vários setores apontam para uma pergunta mais útil para líderes de tecnologia, risco e operações: quais resultados para o cliente ainda funcionam quando uma dependência compartilhada falha, e como a organização saberá quando a recuperação está genuinamente completa?
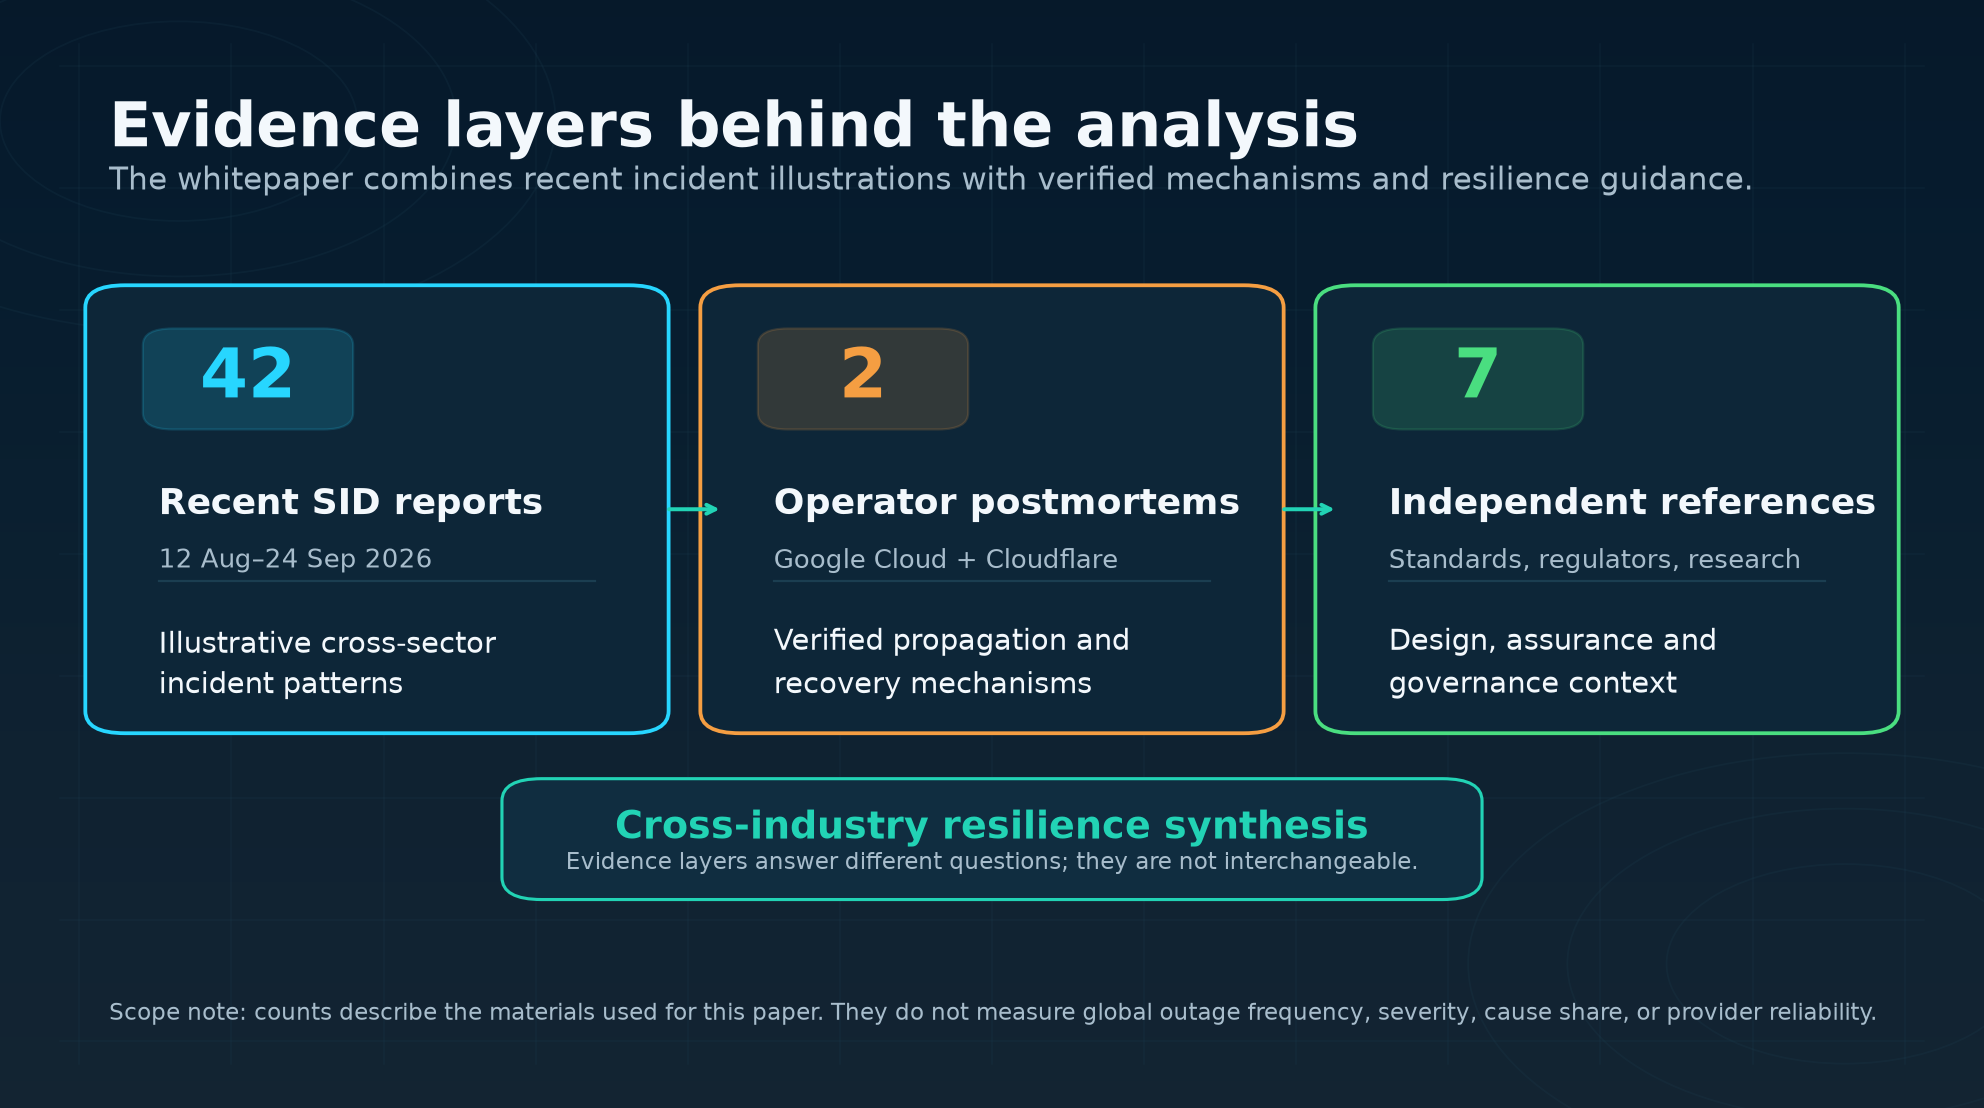
Este documento analisa um corpus editorial de 42 postagens do Status Is Down publicado de 12 de agosto a 24 de setembro de 2026, e em seguida compara essas ilustrações com post-mortem de operadores e orientações regulatórias ou de padrões. O corpus não é um conjunto de dados de interrupção global estatisticamente representativo, portanto, não pode estabelecer frequência de incidentes, confiabilidade comparativa ou uma causa dominante. No entanto, pode expor questões de design recorrentes em plataformas de nuvem, telecomunicações, bancos, comunicações de emergência e transporte.
A descoberta central é que a concentração de dependências eficaz pode transformar uma falha estreita de controle, ambiental, de roteamento, de identidade ou de processamento em um incidente multisserviço. A degradação elegante pode reduzir essa exposição preservando um serviço mínimo definido, seguro e claramente comunicado. A resiliência deve, portanto, ser avaliada com base em resultados críticos e normalização verificada — não por contagem de fornecedores, uma única porcentagem de disponibilidade ou o momento em que um provedor upstream publica “resolvido”.
Resumo executivo
A dependência mais importante de uma organização nem sempre é seu fornecedor mais visível. Pode ser um caminho de autenticação compartilhado, um sistema de distribuição de configuração, um processador central, uma planta de resfriamento de data center, um circuito de transporte, uma plataforma de status ou um canal de suporte. Essas funções formam um núcleo de dependência eficaz: um pequeno conjunto de domínios de falha que podem interromper muitos serviços ou jornadas do cliente de uma vez.
A degradação elegante é o contrapeso prático. Significa preservar deliberadamente um resultado limitado, seguro e inteligível durante uma falha. Não significa aceitar silenciosamente um serviço inferior, assumindo que um canal alternativo funciona para todos os clientes, ou declarar sucesso enquanto filas e trabalhos de reconciliação se acumulam. O modo degradado precisa de capacidade explícita, integridade e limites de comunicação com os clientes, seguidos por um retorno verificado à operação normal.
| Pergunta sobre resiliência | Provas que os líderes devem exigir |
|---|---|
| Onde está a dependência concentrada? | Um mapa de domínios lógicos, físicos, administrativos e de falha de terceiros — não apenas uma lista de fornecedores. |
| O que ainda é seguro de usar? | Um serviço mínimo testado para cada resultado importante para o cliente ou público, com limites e alternativas declaradas. |
| Quando a recuperação está completa? | Provas de que as pendências, integridade de dados, serviço regional, canais de suporte e fluxos de trabalho dependentes foram normalizados. |
Onde a concentração se esconde
A concentração lógica pode ser tão consequente quanto um cabo danificado ou uma fonte de energia falhada. No relatório do Microsoft 365 e ChatGPT Work, a Microsoft atribuiu o impacto contínuo a um problema de configuração de autenticação central que afetou o Exchange Online e serviços de colaboração e segurança conectados. O evento do ChatGPT descrito no mesmo artigo foi separado; a proximidade no tempo não estabeleceu uma causa comum. Um relatório de AI multi-fornecedor posterior aplicou a mesma salvaguarda: incidentes de produtos simultâneos não eram evidências de uma falha de nuvem compartilhada.
Dois post-mortems de primeira parte mostram como a propagação pode amplificar uma mudança estreita. Google Cloud relatou que campos em branco não intencionais nos dados da política de cota se replicaram globalmente em segundos, exercitaram um caminho de código do Service Control inadequadamente protegido e causaram loops de falha. A maioria das regiões começou a se recuperar depois que o caminho da política foi desativado, enquanto um efeito de reagrupamento de reinício estendeu a recuperação em uma grande região e alguns produtos apresentaram pendências residuais. O Google também afirmou que a infraestrutura de monitoramento de saúde e alguns clientes estavam prejudicados.
Cloudflare rastreou separadamente seu incidente de novembro de 2025 a uma mudança de permissão de banco de dados que duplicou um arquivo da funcionalidade de Bot Management. O arquivo superdimensionado se propagou pela rede e excedeu um limite de software. A Cloudflare descartou explicitamente um ciberataque. O tráfego central estava em grande parte normal às 14:30 UTC, mas todos os sistemas não foram relatados como normais até às 17:06 UTC. Esses mecanismos não explicam os incidentes de 2026; eles demonstram por que a geração, validação, rollout, rollback e observabilidade de configuração pertencem ao modelo de falha de produção.
A concentração física e operacional também pode derrotar um backup nominal. No incidente de telecomunicações do aeroporto do Nordeste, um circuito de comunicação primário falhou enquanto uma rota de fibra de backup também estava indisponível ao ser cortada. Os reparos permitiram que as operações fossem retomadas, mas a interrupção acumulada de voos permaneceu. Uma segunda linha em um diagrama não é prova de resiliência se compartilhar um corredor, instalação, plano de controle, fonte de energia ou restrição de reparo com a primeira.
Serviço parcial não é o mesmo que disponibilidade
Os casos financeiros mostram por que os resultados dos clientes devem ser avaliados separadamente. Durante uma falha de aplicativo no Reino Unido, o relatório da Monzo descreveu um arranjo independente de banco de backup e pagamentos com cartão, saques de dinheiro, congelamento de cartões e transferências enquanto algumas funções do aplicativo eram limitadas. No incidente do NAB, o banco digital, negociações e contato telefônico foram afetados, enquanto os caixas eletrônicos e pagamentos rápidos permaneceram disponíveis e um prazo de Direct Entry foi prorrogado. Nenhum dos exemplos significa que cada cliente tinha um substituto adequado; mostra que uma organização pode projetar continuidade em torno de tarefas específicas, em vez de uma interface.
Dependências compartilhadas podem produzir impactos irregulares. O resumo do processador Mastercard do Status Is Down documentou diferentes estados de processadores e rotas, sem reivindicar uma falha universal de pagamento ou uma causa técnica final. O relatório da Sharetec descreveu a interrupção específica da instituição após as cooperativas de crédito afetadas atribuirem o incidente a problemas de resfriamento e failover em um provedor de serviços central compartilhados. A restauração central não significou automaticamente que os saldos, o banco digital e cada fluxo de trabalho de membro foram reconciliados ao mesmo tempo.
Essa estrutura orientada a resultados é refletida na CPS 230 da APRA. Para instituições australianas reguladas, ela exige tolerâncias para a máxima interrupção, perda de dados e serviço mínimo sob arranjos alternativos para operações críticas. O FFIEC igualmente exige análise de pontos únicos de falha e dependências em processamento central, banco online e móvel, liquidação, utilitários e terceiros. Esses são requisitos e orientações setoriais específicos, não regras legais universais, mas o princípio de design é bem aplicável: defina a tarefa que deve continuar antes de selecionar o backup.
Comunicações de emergência e transporte expõem riscos específicos de caminho
A comunicação de emergência não é um único caminho. O relatório de 911 de Oklahoma diferenciou a conclusão de chamadas fixas de problemas de roteamento sem fio e descreveu linhas de dez dígitos alternadas e transferências usadas durante a interrupção. Não estabeleceu que todos os centros de chamadas de Oklahoma falharam simultaneamente, e nenhuma fonte revisada forneceu um total de chamadas falhadas ou causa raiz mais específica. Cuidado semelhante é necessário sempre que voz, texto, dados de localização, roteamento e entrega local de call centers tenham estados diferentes.
Nos Estados Unidos, a FCC exige que os provedores cobertos completem chamadas de 911, transmitam informações de localização, abordem a diversidade de circuitos, forneçam energia de backup e monitoramento, e notifiquem as instalações de 911 afetadas sobre interrupções que possam afetá-las. Essas regras são específicas para a jurisdição. Durante qualquer interrupção ativa dos serviços de emergência, os leitores devem seguir as instruções atuais da autoridade local relevante, em vez de tratar uma página de monitoramento geral ou de notícias como um substituto.
Sistemas de transporte tornam a cauda de recuperação visível. Comunicações restauradas podem reabrir um caminho operacional enquanto aeronaves, equipes e passageiros permanecem fora de posição. A infraestrutura ferroviária reparada pode permitir serviço enquanto atrasos residuais continuam. A lição não é que cada incidente de transporte compartilha uma causa upstream; é que o estado do ativo habilitador e o estado do resultado público são fatos operacionais diferentes.
A recuperação é uma sequência, não um rótulo
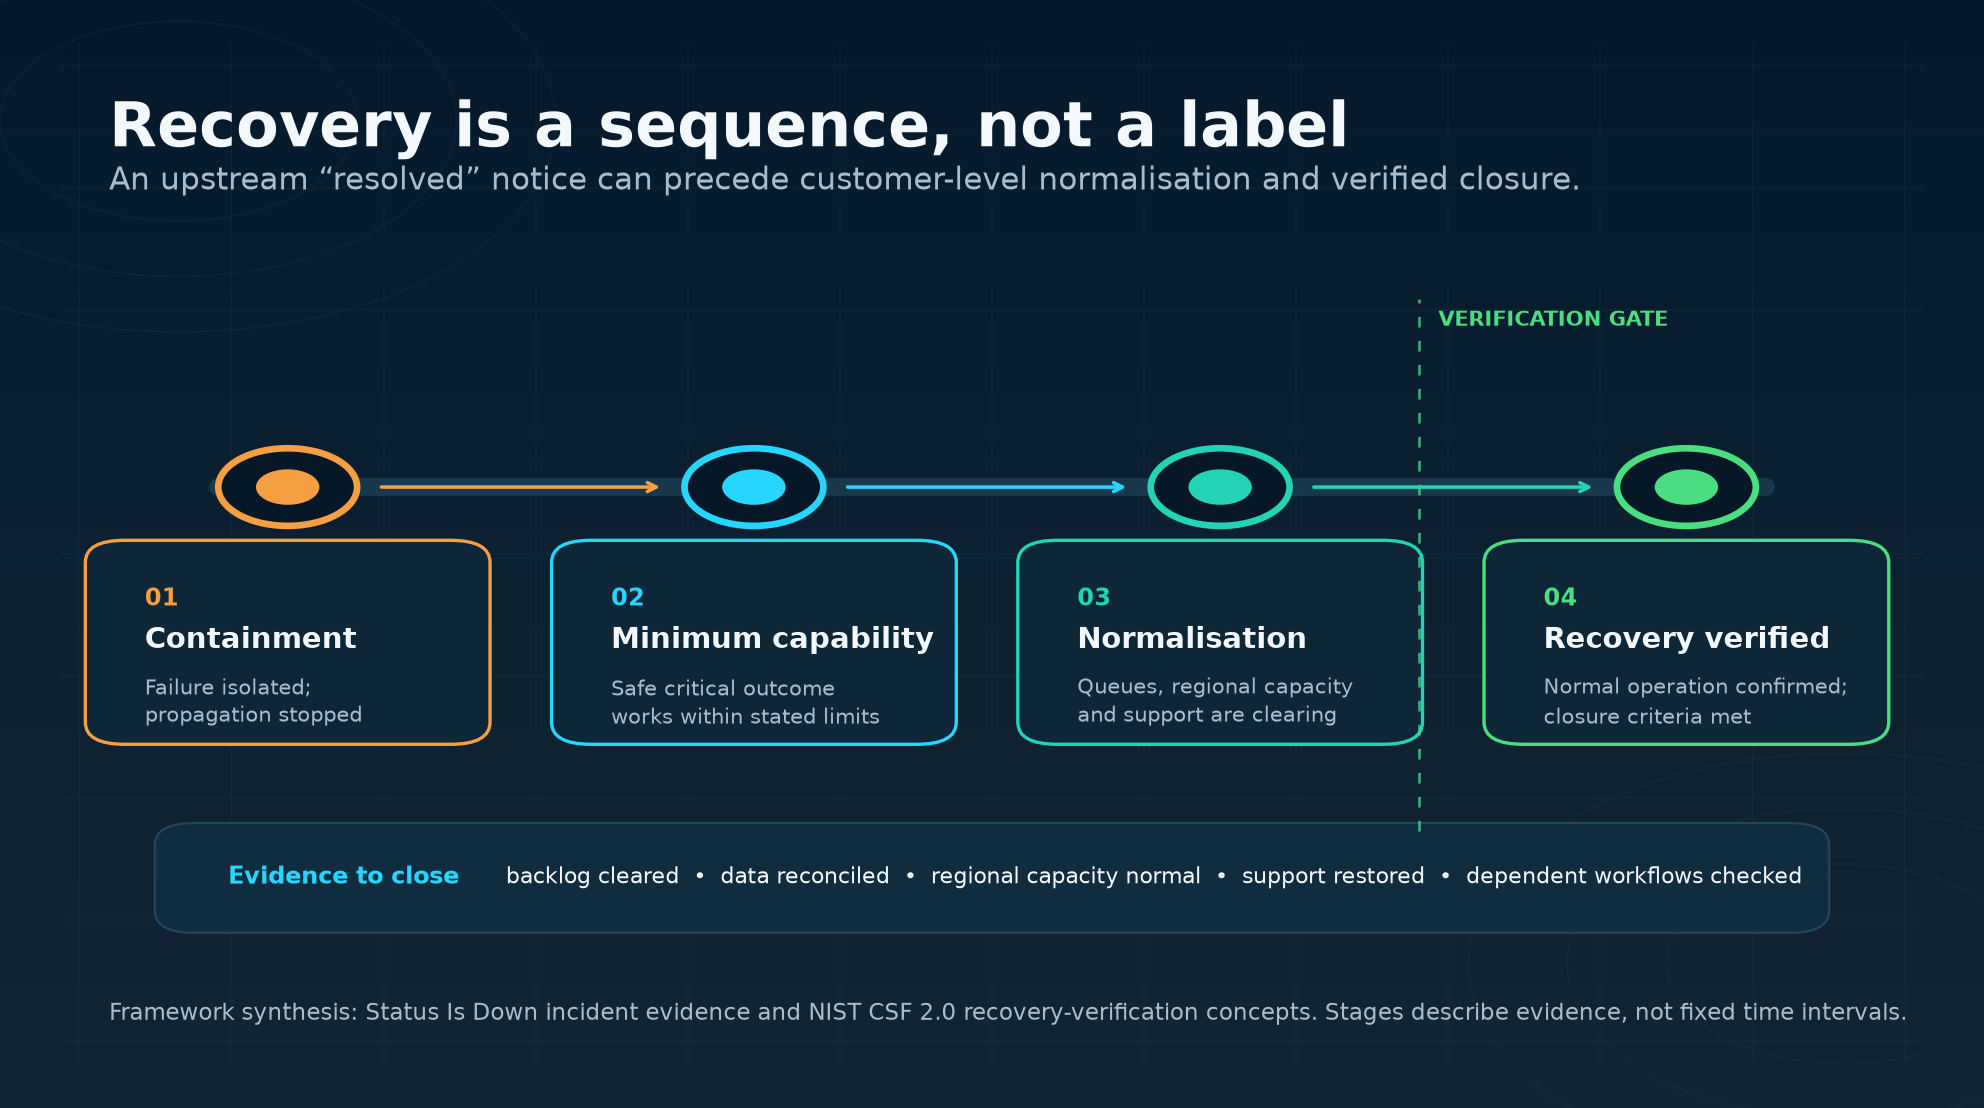
Uma linguagem precisa de recuperação reduz falsos confortos e torna a verificação mais fácil. Um modelo prático de quatro etapas é:
- Contenção: a falha é isolada ou sua propagação é interrompida.
- Capacidade mínima restaurada: um resultado crítico definido ou caminho alternativo seguro está disponível dentro de seus limites declarados.
- Normalização em andamento: filas, trabalhos atrasados, capacidade regional, suporte ao cliente, consistência de dados e fluxos de trabalho dependentes estão sendo limpos ou verificados.
- Recuperação declarada completa: integridade e status operacional normal foram verificados em relação a critérios de fechamento explícitos.
Essa distinção aparece nas evidências dos incidentes. A J:COM relatou recuperação de serviço listado enquanto chamadas ao centro de atendimento ao cliente permaneceram difíceis. O reparo de telecomunicações do aeroporto permitiu que as operações fossem retomadas antes que os horários se normalizassem. O Google Cloud e a Cloudflare registraram ambos uma lacuna entre a recuperação ampla ou central e o fim dos efeitos residuais.
O NIST Cybersecurity Framework 2.0 formaliza a etapa de verificação para incidentes cibernéticos: ações de recuperação são selecionadas e priorizadas, ativos de restauração são verificados, integridade de ativos restaurados e status operacional normal são confirmados, e o fim da recuperação é declarado de acordo com critérios. A mesma disciplina é útil além da cibersegurança, mesmo onde o incidente começa com energia, resfriamento, telecomunicações ou um erro operacional.
Um programa de cinco partes para degradação elegante
Primeiro, mapeie o resultado importante e cada domínio de falha que o habilita. Siga identidade, DNS, entrega de borda, planos de controle, APIs, processadores, data centers, transportadoras, monitoramento e suporte, incluindo quarto partidos e rotas físicas. O quadro DORA da UE trata a concentração de terceiros em ICT críticos como uma preocupação de resiliência operacional em finanças; outros setores podem usar a mesma lente analítica sem supor que a regulação se aplica a eles.
Segundo, defina o modo mínimo viável. Declare quais tarefas dos clientes continuam, quais dados podem ser atrasados, quem recebe prioridade, qual limite de capacidade se aplica e como o trabalho adiado será reconciliado. Uma alternativa que é insegura, inacessível ou muito pequena para a demanda não é um serviço degradado credível.
Terceiro, projete contenção e failover. Dependendo do sistema, os controles podem incluir rollout em etapas, validação, flags de recursos, botões de desligamento, tentativas limitadas, retrocessos exponenciais aleatórios, disjuntores, filas, caches, políticas de sessão e soluções manuais. O pós-mortem do Google identificou vários desses como áreas de remediação; o conjunto exato de controles deve se encaixar no serviço e em seu risco.
Quarto, preserve a observabilidade e comunicação independentes. A página de status, pilha de monitoramento e canal de suporte podem compartilhar a mesma dependência que a produção. As organizações devem identificar uma maneira separada de observar os resultados dos clientes e publicar atualizações aprovadas que distingam sintomas, escopo confirmado, status da causa, soluções temporárias, restauração de capacidade, normalização e fechamento.
Cinquenta, teste a falha combinada. As orientações sobre resiliência operacional da FCA pedem que as empresas mapeiem pessoas, processos, tecnologia, instalações, informações e terceiros, e em seguida testem cenários severos, mas plausíveis. Ela também distingue objetivos de tempo de recuperação de tolerâncias de impacto e observa que as ações de resposta podem ganhar tempo enquanto a recuperação é concluída. Um exercício útil deve, portanto, testar perda de dependência, serviço parcial, comunicações normais indisponíveis, sobrecarga de suporte e limpeza de pendências juntos — não apenas se um servidor de backup liga.
Medições que os conselhos podem usar
Uma única porcentagem de disponibilidade não pode mostrar se um cliente completou um pagamento, acessou serviços de emergência, fez check-in para um voo ou acessou uma função crítica da conta. Medidas orientadas a resultados podem incluir tempo para detectar, tempo para a primeira contingência utilizável, a porcentagem ou volume de tarefas críticas concluídas com segurança, idade da fila, exceções de reconciliação, disponibilidade do canal de suporte, tempo para operações normais verificadas e riscos de recuperação não resolvidos.
A análise de 2026 do Uptime Institute fornece contexto mais amplo: relata que a frequência de interrupção por local diminuiu pelo quinto ano, enquanto falhas na infraestrutura externa tornaram-se mais proeminentes em interrupções publicamente relatadas e incidentes de fibra e conectividade eram mais propensos a produzir interrupções prolongadas. Suas evidências combinam pesquisas, relatórios públicos, membros, parceiros e seu próprio banco de dados. Essas descobertas não devem ser tratadas como um censo do corpus do Status Is Down, mas reforçam a necessidade de olhar além dos equipamentos internos e mapear dependências externas.
O que isso significa para os usuários do Status Is Down
O Status Is Down pode apoiar esse trabalho ajudando as equipes a comparar sinais de usuários atuais com atualizações de operadores em seus registros de site, diretório de serviços e painel em tempo real. Esses recursos complementam, em vez de substituir, as instruções oficiais de provedores, emergências ou transporte.
Criar uma conta e selecionar um plano de monitoramento pode ajudar equipes a acompanhar os serviços externos dos quais dependem e adicionar contexto à sua própria telemetria. A tarefa de resiliência maior permanece organizacional: defina o resultado crítico, teste o modo degradado e verifique o caminho de volta ao normal. Os leitores também podem explorar pesquisas adicionais na coleção de Whitepapers da Indústria.
Metodologia e limites
O material do Status Is Down usado aqui é um corpus editorialmente selecionado e vinculado a fontes, não um estudo de prevalência. Contagens de artigos não podem apoiar reivindicações sobre frequência, gravidade, geografia, duração, confiabilidade comparativa ou participação de causa raiz. Relatórios contemporâneos também podem ser revisados por análises posteriores de operadores. A linguagem da causa, portanto, permanece restrita: confirmada onde existe um post-mortem, atribuída onde um operador ou instituição forneceu um relato, e não divulgada onde as evidências não estabeleceram mais.
Constituição não é causalidade. Sintomas semelhantes ou temporização sobreposta não provam uma falha de nuvem compartilhada, transportadora, ciberataque, evento de sabotagem ou falha do fornecedor. A disponibilidade parcial também não é prova de inofensividade: um caixa eletrônico, rota de cartão, número alternativo ou canal de texto pode ter limites de elegibilidade, capacidade, acessibilidade ou geográficos. Finalmente, as fontes regulatórias neste documento descrevem seus próprios setores e jurisdições e não devem ser lidas como aconselhamento legal.
Conclusão
Um serviço resiliente não promete que cada componente permanecerá disponível para sempre. Torna as fronteiras de dependência visíveis, limita o raio de explosão, preserva resultados críticos definidos onde é seguro, comunica o que os usuários podem e não podem fazer, e declara que a recuperação está completa somente após verificação. Para os líderes que revisam as tendências recentes de interrupção, a degradação elegante não é uma versão mais suave da disponibilidade; é a disciplina operacional que transforma dependências concentradas em risco delimitado e mensurável.
Fontes
- Status Is Down: Interrupção do Microsoft 365 deixa um pequeno subconjunto afetado no terceiro dia; ChatGPT Work se recupera após cinco horas de interrupção
- Status Is Down: Interrupções do ChatGPT e Claude atingem usuários de AI enquanto relatos se espalham por Gemini, Copilot e Grok
- Status Is Down: Cuba inicia recuperação da rede após apagão nacional; interrupção da Sharetec afeta cooperativas de crédito
- Status Is Down: A J:COM restaura a banda larga após ampla interrupção no Japão; NAB resolve a interrupção do banco digital
- Status Is Down: Operações do aeroporto do Nordeste são retomadas após interrupção de telecomunicações; recuperação da utilidade do estado do Michigan continua
- Status Is Down: Pagamentos da Mastercard falham mundialmente: cinco processadores relatam erros antes que a recuperação comece
- Status Is Down: Monzo ativa banco de backup em meio à interrupção do aplicativo no Reino Unido; falha na reserva da IndiGo bloqueia reservas na Índia
- Status Is Down: Oklahoma restaura roteamento de 911 após problema na rede; postes derrubados interrompem o serviço ferroviário de Long Island
- Google Cloud: Vários produtos do GCP estão enfrentando problemas de serviço
- Cloudflare: Interrupção do Cloudflare em 18 de novembro de 2025
- Uptime Institute: Relatório Anual de Análise de Interrupção 2026
- Instituto Nacional de Padrões e Tecnologia: O Framework de Cibersegurança NIST (CSF) 2.0
- Autoridade de Conduta Financeira: Resiliência operacional: percepções e observações para empresas
- Comissão Federal de Comunicações: Confiabilidade do 911
- Autoridade Australiana de Regulamentação Prudencial: Padrão Prudencial CPS 230 Gestão de Risco Operacional
- Autoridade Europeia de Seguros e Pensões Ocupacionais: Ato de Resiliência Operacional Digital (DORA)
- Conselho Federal de Exames de Instituições Financeiras: Gestão de Continuidade de Negócios: Análise de Interdependência
Crédito da imagem: Ilustração gerada para Status Is Down