Когда «Недоступен» не значит «Ушел»: разработка плавного ухудшения для концентрированных цифровых зависимостей
Большинство отчетов об отключениях начинается с бинарного вопроса: работает ли сервис или нет? Недавние инциденты между отраслями указывают на более полезный вопрос для руководителей в области технологий, рисков и операций: какие результаты для клиентов все еще действуют, когда общая зависимость терпит неудачу, и как организация узнает, когда восстановление действительно завершено?
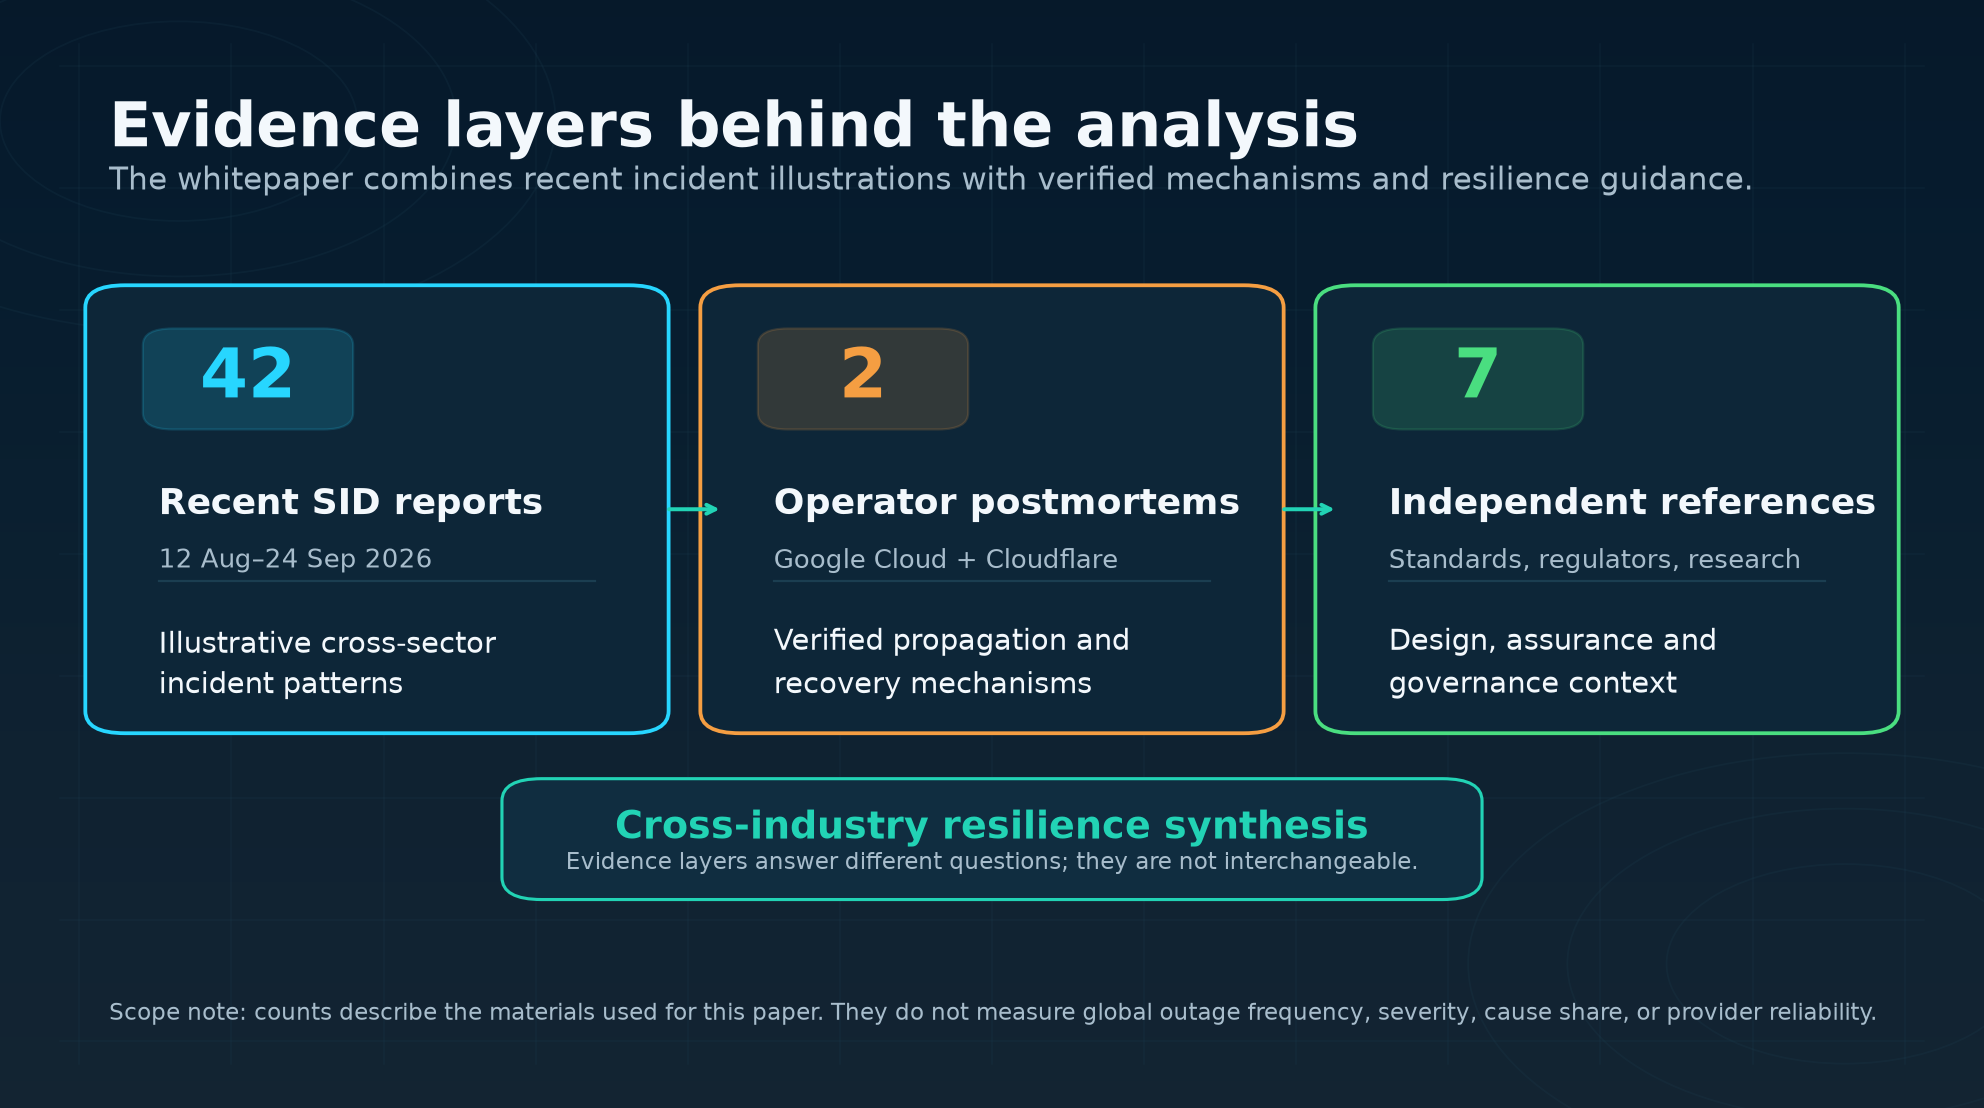
Этот документ рассматривает корпус из 42 публикаций Status Is Down, опубликованных с 12 августа по 24 сентября 2026 года, затем сравнивает эти иллюстрации с постмортемами операторов и регуляторными или стандартными указаниями. Корпус не является статистически представительным глобальным набором данных об отключениях, поэтому он не может установить частоту инцидентов, сравнительную надежность или доминирующую причину. Тем не менее, он может выявить повторяющиеся проектные вопросы на облачных платформах, в телекоммуникациях, банковском деле, экстренных коммуникациях и транспорте.
Центральная находка заключается в том, что эффективная концентрация зависимостей может превратить узкую проблему управления, окружающей среды, маршрутизации, идентификации или обработки в инцидент многофункциональной продукции. Плавное ухудшение может уменьшить этот риск, сохраняя четко определенную, безопасную и понятную минимальную услугу. Устойчивость, следовательно, следует оценивать по критически важным результатам и подтвержденной нормализации — а не по количеству поставщиков, одному проценту доступности или моменту, когда поставщик выше по цепочке сообщает о «разрешенной» ситуации.
Исполнительное резюме
Самая важная зависимость организации не всегда является ее самым заметным поставщиком. Это может быть общий путь аутентификации, система распространения конфигурации, центральный процессор, система охладителя дата-центра, операторская цепь, платформа статуса или канал поддержки. Эти функции формируют эффективное ядро зависимости: небольшой набор областей отказа, которые могут одновременно прервать множество брендов услуг или клиентских путей.
Плавное ухудшение является практическим противовесом. Оно означает преднамеренное сохранение ограниченного, безопасного и понятного результата во время ухудшения работы. Это не означает безмолвного принятия худшего сервиса, предположив, что один альтернативный канал подходит для каждого клиента, или объявления о успехе, когда накапливаются очереди и работа по реконсиляции. Режим ухудшения требует четких границ по емкости, целостности и коммуникации с клиентами, за которыми следует подтвержденное восстановление нормальной работы.
| Вопрос устойчивости | Доказательства, которые должны потребовать руководители |
|---|---|
| Где сосредоточена зависимость? | Карта логических, физических, административных и сторонних областей отказа — не просто список поставщиков. |
| Что остается безопасно используемым? | Проверенная минимальная услуга для каждого важного результата для клиентов или общества с обозначенными пределами и альтернативами. |
| Когда восстановление завершено? | Доказательства того, что накопленные отставания, целостность данных, региональная служба, каналы поддержки и зависимые рабочие процессы нормализованы. |
Где скрывается концентрация
Логическая концентрация может быть столь же значительной, как поврежденный кабель или вышедший из строя источник питания. В отчете Status Is Down Microsoft 365 и ChatGPT Work Microsoft объяснила продолжающееся воздействие проблемой конфигурации аутентификации, достигшей Exchange Online и связанных с ним услуг по совместной работе и безопасности. Инцидент ChatGPT, описанный в той же статье, был отдельным событием; близость во времени не установила общую причину. Позднее многофункциональный отчет о AI применил ту же предосторожность: одновременные инциденты продукции не были свидетельством одной общей облачной аварии.
Два постмортема от первичных источников показывают, как распространение может усиливать узкие изменения. Google Cloud сообщил, что непреднамеренные пустые поля в данных политики квот были воспроизведены по всему миру в течение нескольких секунд, использовали недостаточно защищенный путь кода управления услугами и вызывали циклы сбоев. Большинство регионов начали восстанавливаться после отключения пути политики, в то время как эффект перезапуска продолжал продлевать восстановление в большом регионе, и в некоторых продуктах оставались остаточные отставания. Google также упомянул, что инфраструктура мониторинга здоровья и некоторых клиентов была повреждена.
Cloudflare отдельно проследил свой инцидент ноября 2025 года к изменению разрешений базы данных, которое удвоило файл функции управления ботами. Увеличенный файл распространился по сети и превысил предел программного обеспечения. Cloudflare прямо исключил возможность кибератаки. Основной трафик был в основном нормальным к 14:30 UTC, но все системы не были сообщены как нормальные до 17:06 UTC. Эти механизмы не объясняют инциденты 2026 года, они демонстрируют, почему генерация конфигурации, проверка, развертывание, откат и наблюдаемость должны быть включены в модель отказов производства.
Физическая и операционная концентрация также могут подорвать номинальный резерв. В инциденте телекоммуникаций аэропорта на Севере-востоке основной коммуникационный контур вышел из строя, в то время как резервный оптоволоконный маршрут также был недоступен после того, как был severed. Ремонт позволил возобновить операции, но накопленные сбои рейсов остались. Вторая линия на диаграмме не является доказательством устойчивости, если она делит коридор, объект, контрольный план, источник питания или ограничение на ремонт с первой.
Частичное обслуживание не то же самое, что доступность
Финансовые примеры показывают, почему результаты для клиентов следует оценивать отдельно. Во время нарушений приложения в Великобритании отчёт Monzo описывал независимую резервную банковскую схему и продолжение обработки карт, наличных, замораживания карт и переводов, в то время как некоторые функции приложения были ограничены. В инциденте NAB были затронуты цифровые банковские услуги, торговля и телефонные контакты, в то время как банкоматы и быстрые переводы оставались доступными, а срок прямого ввода был продлен. Ни один из примеров не означает, что у каждого клиента была адекватная замена; это показывает, что организация может спроектировать непрерывность вокруг конкретных задач, а не одного интерфейса.
Общие зависимости могут производить неравномерное воздействие. Отчет Status Is Down о процессорах Mastercard задокументировал различные состояния процессоров и маршрутов, не заявляя о универсальном сбое платежей или конечной технической причине. Отчет Sharetec описал специфические сбои для институций после того, как затронутые кредитные союзы атрибутировали инцидент проблемам с охлаждением и резервированием при общем провайдере основных услуг. Восстановление основной системы не означало, что балансы, цифровое банковское обслуживание и каждый рабочий процесс были восстановлены одновременно.
Такое представление, ориентированное на результаты, отражено в CPS 230 APRA. Для регулируемых австралийских учреждений это требует допусков для максимальных сбоев, потерь данных и минимальной службы при альтернативных условиях для критически важных операций. FFIEC аналогично требует анализа единичных точек отказа и зависимостей в ключевых процессах, онлайн и мобильном банкинге, расчетах, коммунальных услугах и третьих лицах. Это специфические для сектора требования и указания, а не универсальные юридические правила, но принцип проектирования хорошо работает: определите задачу, которая должна продолжаться, перед выбором резервного варианта.
Экстренные коммуникации и транспорт выявляют риски конкретных путей
Экстренная связь не является одним путем. Отчет Oklahoma 911 различает завершение звонков по проводной связи и проблемы с маршрутизацией по беспроводной связи, а также описывает альтернативные десятизначные линии и переводы, используемые во время сбоя. Он не установил, что каждый центр вызовов Оклахомы вышел из строя одновременно, и ни один пересмотренный источник не предоставил общего количества несостоявшихся звонков или более конкретной коренной причины. Аналогичная осторожность необходима каждый раз, когда голосовые, текстовые, геолокационные данные, маршрутизация и доставка местных центров вызовов имеют разные состояния.
В Соединенных Штатах FCC требует, чтобы покрываемые поставщики завершали звонки 911, передавали информацию о местоположении, учитывали разнообразие цепей, резервное питание и мониторинг, а также уведомляли затронутые учреждения 911 о сбоях, которые могут на них повлиять. Эти правила специфичны для юрисдикции. Во время любого активного сбоя службы экстренной помощи читатели должны следовать текущим указаниям соответствующего местного органа вместо того, чтобы рассматривать общую страницу мониторинга или новостей в качестве замены.
Транспортные системы делают видимым «хвост восстановления». Восстановление связи может открыть рабочий путь, в то время как самолеты, экипажи и пассажиры остаются в неустановленном положении. Отремонтированная железнодорожная инфраструктура может позволить возобновление услуг, в то время как остаточные задержки продолжаются. Урок заключается не в том, что каждый инцидент в транспорте имеет общую причину; он заключается в том, что статус включающего актива и статус общественного результата — это разные операционные факты.
Восстановление — это последовательность, а не ярлык
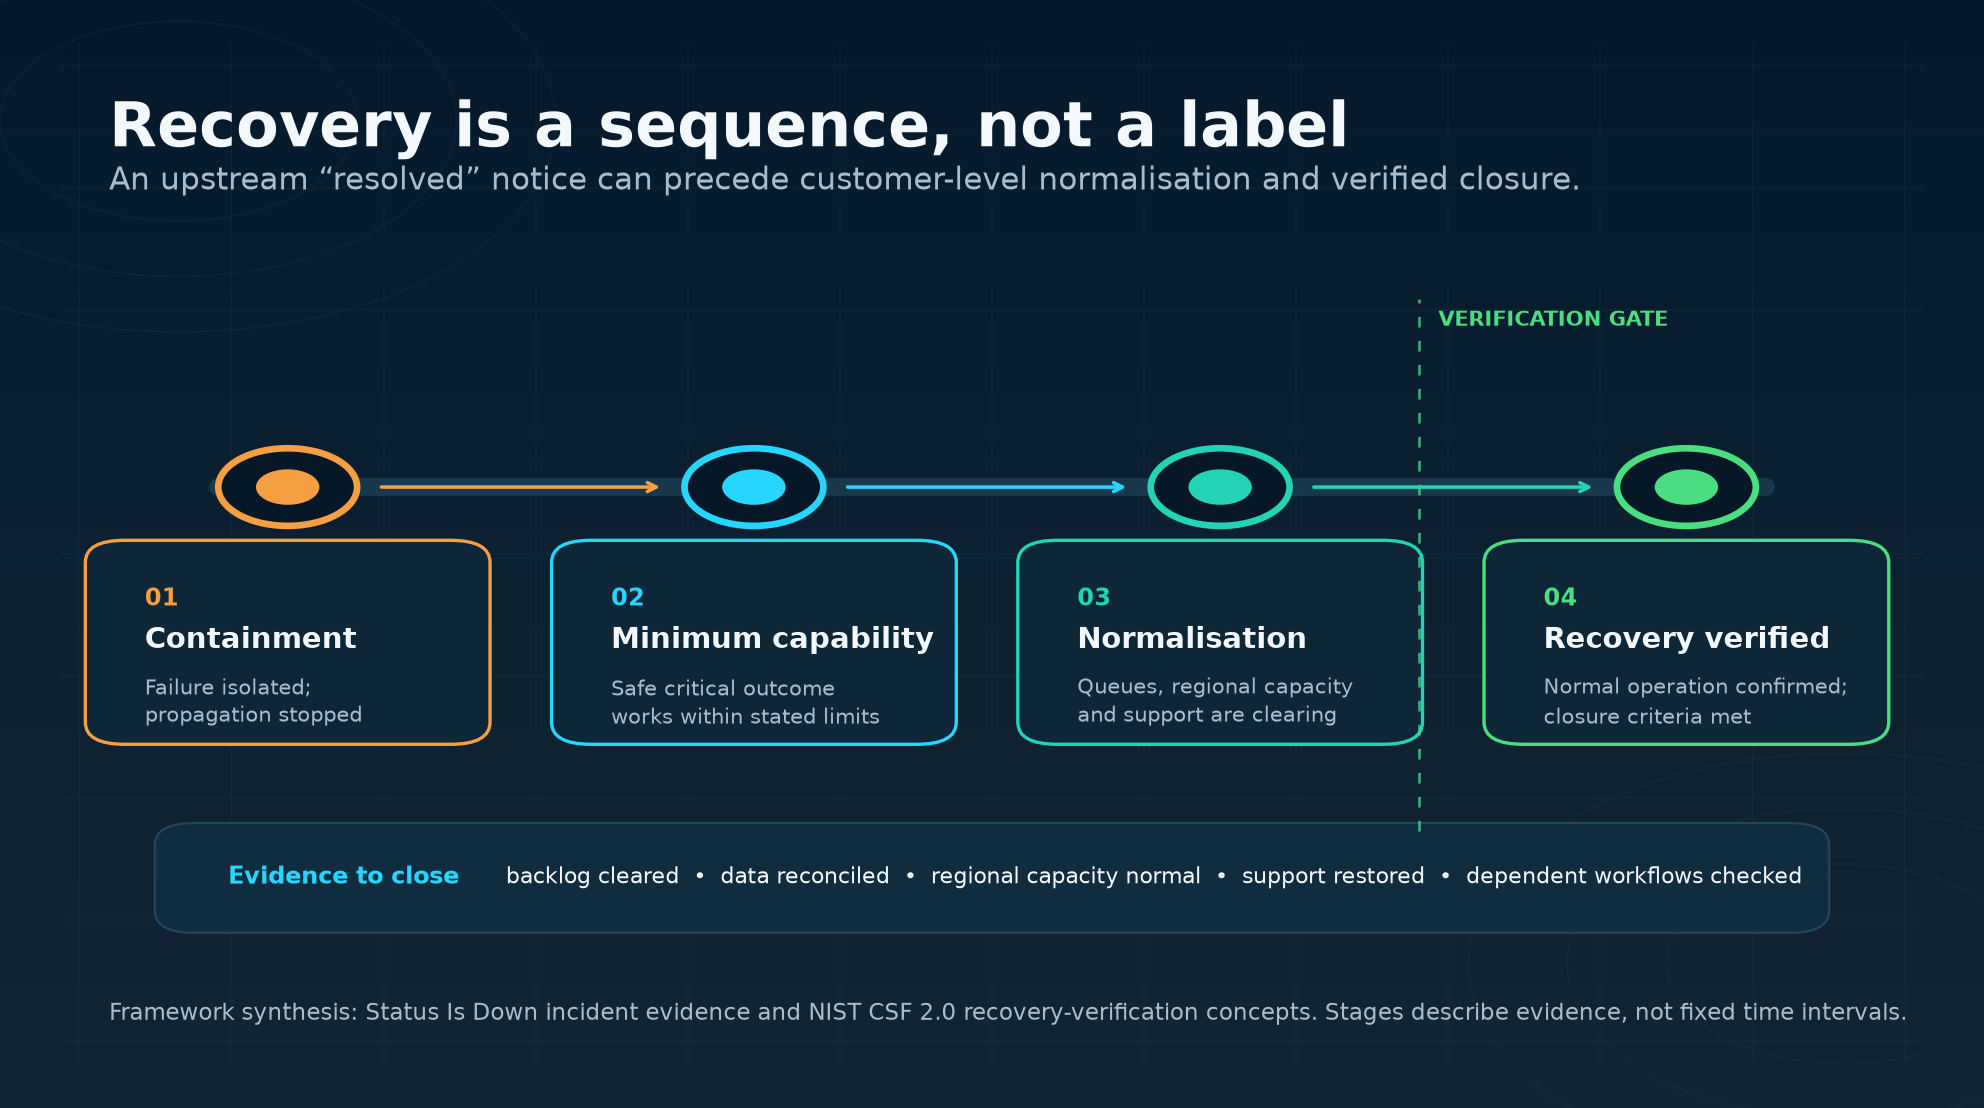
Точный язык восстановления снижает ложное успокаивающее чувство и облегчает проверку. Практическая модель из четырех этапов:
- Сдерживание: отказ изолируется или его распространение останавливается.
- Восстановлена минимальная способность: доступен определенный критический результат или безопасный альтернативный путь в рамках обозначенных пределов.
- Нормализация в процессе: очереди, задержанные задания, региональная емкость, поддержка клиентов, согласованность данных и зависимые рабочие процессы проверяются или очищаются.
- Восстановление объявлено завершенным: целостность и нормальный рабочий статус были подтверждены по четким критериям закрытия.
Это различие обнаруживается в доказательствах инцидента. J:COM сообщила о восстановлении перечисленных услуг, в то время как звонки в центр обслуживания клиентов оставались затруднительными. Ремонт телекоммуникаций аэропорта позволил возобновить операции до нормализации расписаний. Google Cloud и Cloudflare оба зафиксировали разрыв между широким или основным восстановлением и завершением остаточных эффектов.
NIST Cybersecurity Framework 2.0 формализует этап проверки для киберинцидентов: выбираются и приоритизируются действия по восстановлению, проверяются активы восстановления, подтверждаются целостность восстановленных активов и нормальный рабочий статус, и конец восстановления объявляется по критериям. Та же дисциплина полезна и за пределами кибербезопасности, даже когда инцидент начинается с питания, охлаждения, телекоммуникаций или операционной ошибки.
Пятичастная программа для плавного ухудшения
Во-первых, нарисуйте важный результат и каждую область отказа, которая его обеспечивает. Следуйте за идентификацией, DNS, доставкой на границе, контрольными плоскостями, API, процессорами, дата-центрами, операторами, мониторингом и поддержкой, включая четвертых лиц и физические маршруты. Регламент DORA ЕС рассматривает концентрацию критической ИКТ зависимостей третьих лиц как проблему операционной устойчивости в финансах; другие сектора могут использовать тот же аналитический подход, не предполагая, что регламенты применимы к ним.
Во-вторых, определите минимальный жизнеспособный режим. Укажите, какие задачи клиентов продолжаются, какие данные могут быть отложены, кто получает приоритет, какой предельный объем применяется и как будет согласована отложенная работа. Альтернатива, которая небезопасна, недоступна или слишком мала для спроса, не является достоверной ухудшенной услугой.
В-третьих, создайте сдерживание и резервирование. В зависимости от системы, контроли могут включать поэтапное развертывание, проверку, флаги функций, аварийные выключатели, ограниченные повторные попытки, случайный экспоненциальный откат, предохранители, очереди, кэши, политику сессий и ручные обходы. Постмортем Google выявил несколько из них как области ремедиации; точный набор контролей должен соответствовать услуге и ее риску.
В-четвертых, сохраните независимую наблюдаемость и связь. Страница статуса, мониторинг и канал поддержки могут разделять ту же зависимость, что и производство. Организации должны определить отдельный способ наблюдения за результатами клиентов и публиковать утвержденные обновления, которые отличают симптомы, подтвержденный объем, статус причины, решения обхода, восстановление способностей, нормализацию и закрытие.
В-пятых, протестируйте совместный сбой. Руководство FCA по операционной устойчивости просит компании в области определить людей, процессы, технологии, объекты, информацию и третьих лиц, а затем протестировать серьезные, но правдоподобные сценарии. Оно также различает цели времени восстановления от допусков воздействия и отмечает, что действия реагирования могут выиграть время, пока продолжается восстановление. Полезное упражнение должно протестировать потерю зависимости, частичное обслуживание, недоступные нормальные коммуникации, перегрузку поддержки и очистку накоплений вместе — а не только способность резервного сервера запуститься.
Меры, которые могут использовать советы директоров
Единичный процент доступности не может показать, завершил ли клиент платеж, связался ли с экстренными службами, зарегистрировался на рейс или получил доступ к критической функции счета. Ориентированные на результаты меры могут включать время для обнаружения, время до первой доступной альтернативы, процент или объем критических задач, завершенных безопасно, возраст очереди, исключения реконсиляции, доступность канала поддержки, время до подтвержденных нормальных операций и нерешенные риски восстановления.
Анализ Uptime Institute 2026 года предоставляет более широкий контекст: он сообщает, что частота сбоев на месте упала пятый год подряд, в то время как сбои внешней инфраструктуры стали более заметными в публично сообщаемых отключениях, а инциденты с оптоволокном и подключением были более вероятны для вызова продолжительных сбоев. Его доказательства объединяют опросы, публичные отчеты, членов, партнеров и свою собственную базу данных. Эти выводы не следует воспринимать как перепись корпуса Status Is Down, но они подчеркивают необходимость смотреть за пределы внутреннего оборудования и отмечать внешние зависимости.
Что это означает для пользователей Status Is Down
Status Is Down может поддержать эту работу, помогая командам сравнивать текущие пользовательские сигналы с обновлениями операторов через свои записи сайта, каталог услуг и панель мониторинга в реальном времени. Эти ресурсы дополняют, а не заменяют официальные инструкции поставщика, экстренные или транспортные инструкции.
Создание учетной записи и выбор плана мониторинга могут помочь командам следовать за внешними услугами, от которых они зависят, и добавить контекст к их собственной телеметрии. Более крупная задача по устойчивости остается организационной: определить критический результат, протестировать режим ухудшения и подтвердить путь назад к норме. Читатели также могут исследовать дополнительное исследование в коллекции отраслевых белых книг.
Методология и пределы
Материалы Status Is Down, использованные здесь, являются редакционно выбранным корпусом с источниками, а не исследованием распространенности. Подсчет статей не может поддержать утверждения о частоте, тяжести, географии, продолжительности, сравнительной надежности или доле коренной причины. Современные отчеты также могут быть пересмотрены позже оператором. Язык причины, следовательно, остается узким: подтвержденным там, где существует постмортем, атрибутированным там, где оператор или учреждение предоставили отчет, и не раскрытым там, где доказательства не установили больше.
Совпадение не является причинностью. Похожие симптомы или наложение времени не доказывают общую облачную, операторскую, кибератаку, акт саботажа или сбой поставщика. Частичная доступность также не является доказательством безобидности: ATM, маршрут карты, альтернативный номер или текстовый канал могут иметь ограничения по правам, емкости, доступности или географии. Наконец, регуляторные источники в этом документе описывают свои собственные сектора и юрисдикции и не должны восприниматься как юридические советы.
Заключение
Устойчивый сервис не обещает, что каждый компонент останется доступным навсегда. Он делает границы зависимостей видимыми, ограничивает радиус разрушительного действия, сохраняет определенные критически важные результаты, где это безопасно, сообщается, что пользователи могут и не могут делать, и завершает восстановление только после проверки.
Источники
- Status Is Down: Отключение Microsoft 365 оставляет небольшую часть затронутой на третий день; ChatGPT Work восстанавливается после пятии часового сбоя
- Status Is Down: Отключения ChatGPT и Claude затрагивают пользователей AI, когда отчеты распространяются по Gemini, Copilot и Grok
- Status Is Down: Куба начинает восстановление сети после национального отключения; отключение Sharetec нарушает работу кредитных союзов
- Status Is Down: J:COM восстанавливает широкополосную связь после масштабного сбоя в Японии; NAB решает сбой цифрового банкинга
- Status Is Down: Операции аэропорта на северо-востоке возобновляются после сбоя телекоммуникаций; восстановление энергетической компании Мичигана продолжается
- Status Is Down: Платежи Mastercard терпят неудачу по всему миру: пять процессоров сообщают об ошибках до начала восстановления
- Status Is Down: Monzo активирует резервный банк на фоне сбоя в приложении в Великобритании; сбой резервирования IndiGo блокирует бронирование в Индии
- Status Is Down: Оklahoma восстанавливает маршрутизацию 911 после проблемы с сетью; поваленные столбы нарушают работу железнодорожной службы на Лонг-Айленде
- Google Cloud: Несколько продуктов GCP терпят сбои в работе
- Cloudflare: Сбой Cloudflare 18 ноября 2025 года
- Uptime Institute: Годовой отчет об анализе сбоев 2026 года
- Национальный институт стандартов и технологий: Рамочная программа кибербезопасности NIST (CSF) 2.0
- Управление по финансовому поведению: Операционная устойчивость: идеи и наблюдения для компаний
- Федеральная комиссия по связи: Надежность 911
- Австралийское управление пенсионного регулирования: Стандарт CPS 230 Операционное управление рисками
- Европейское управление по страхованию и пенсиям: Закон о цифровой операционной устойчивости (DORA)
- Совет по экзаменам финансовых учреждений: Управление непрерывностью бизнеса: Анализ взаимозависимости
Источник изображения: Иллюстрация, созданная для Status Is Down