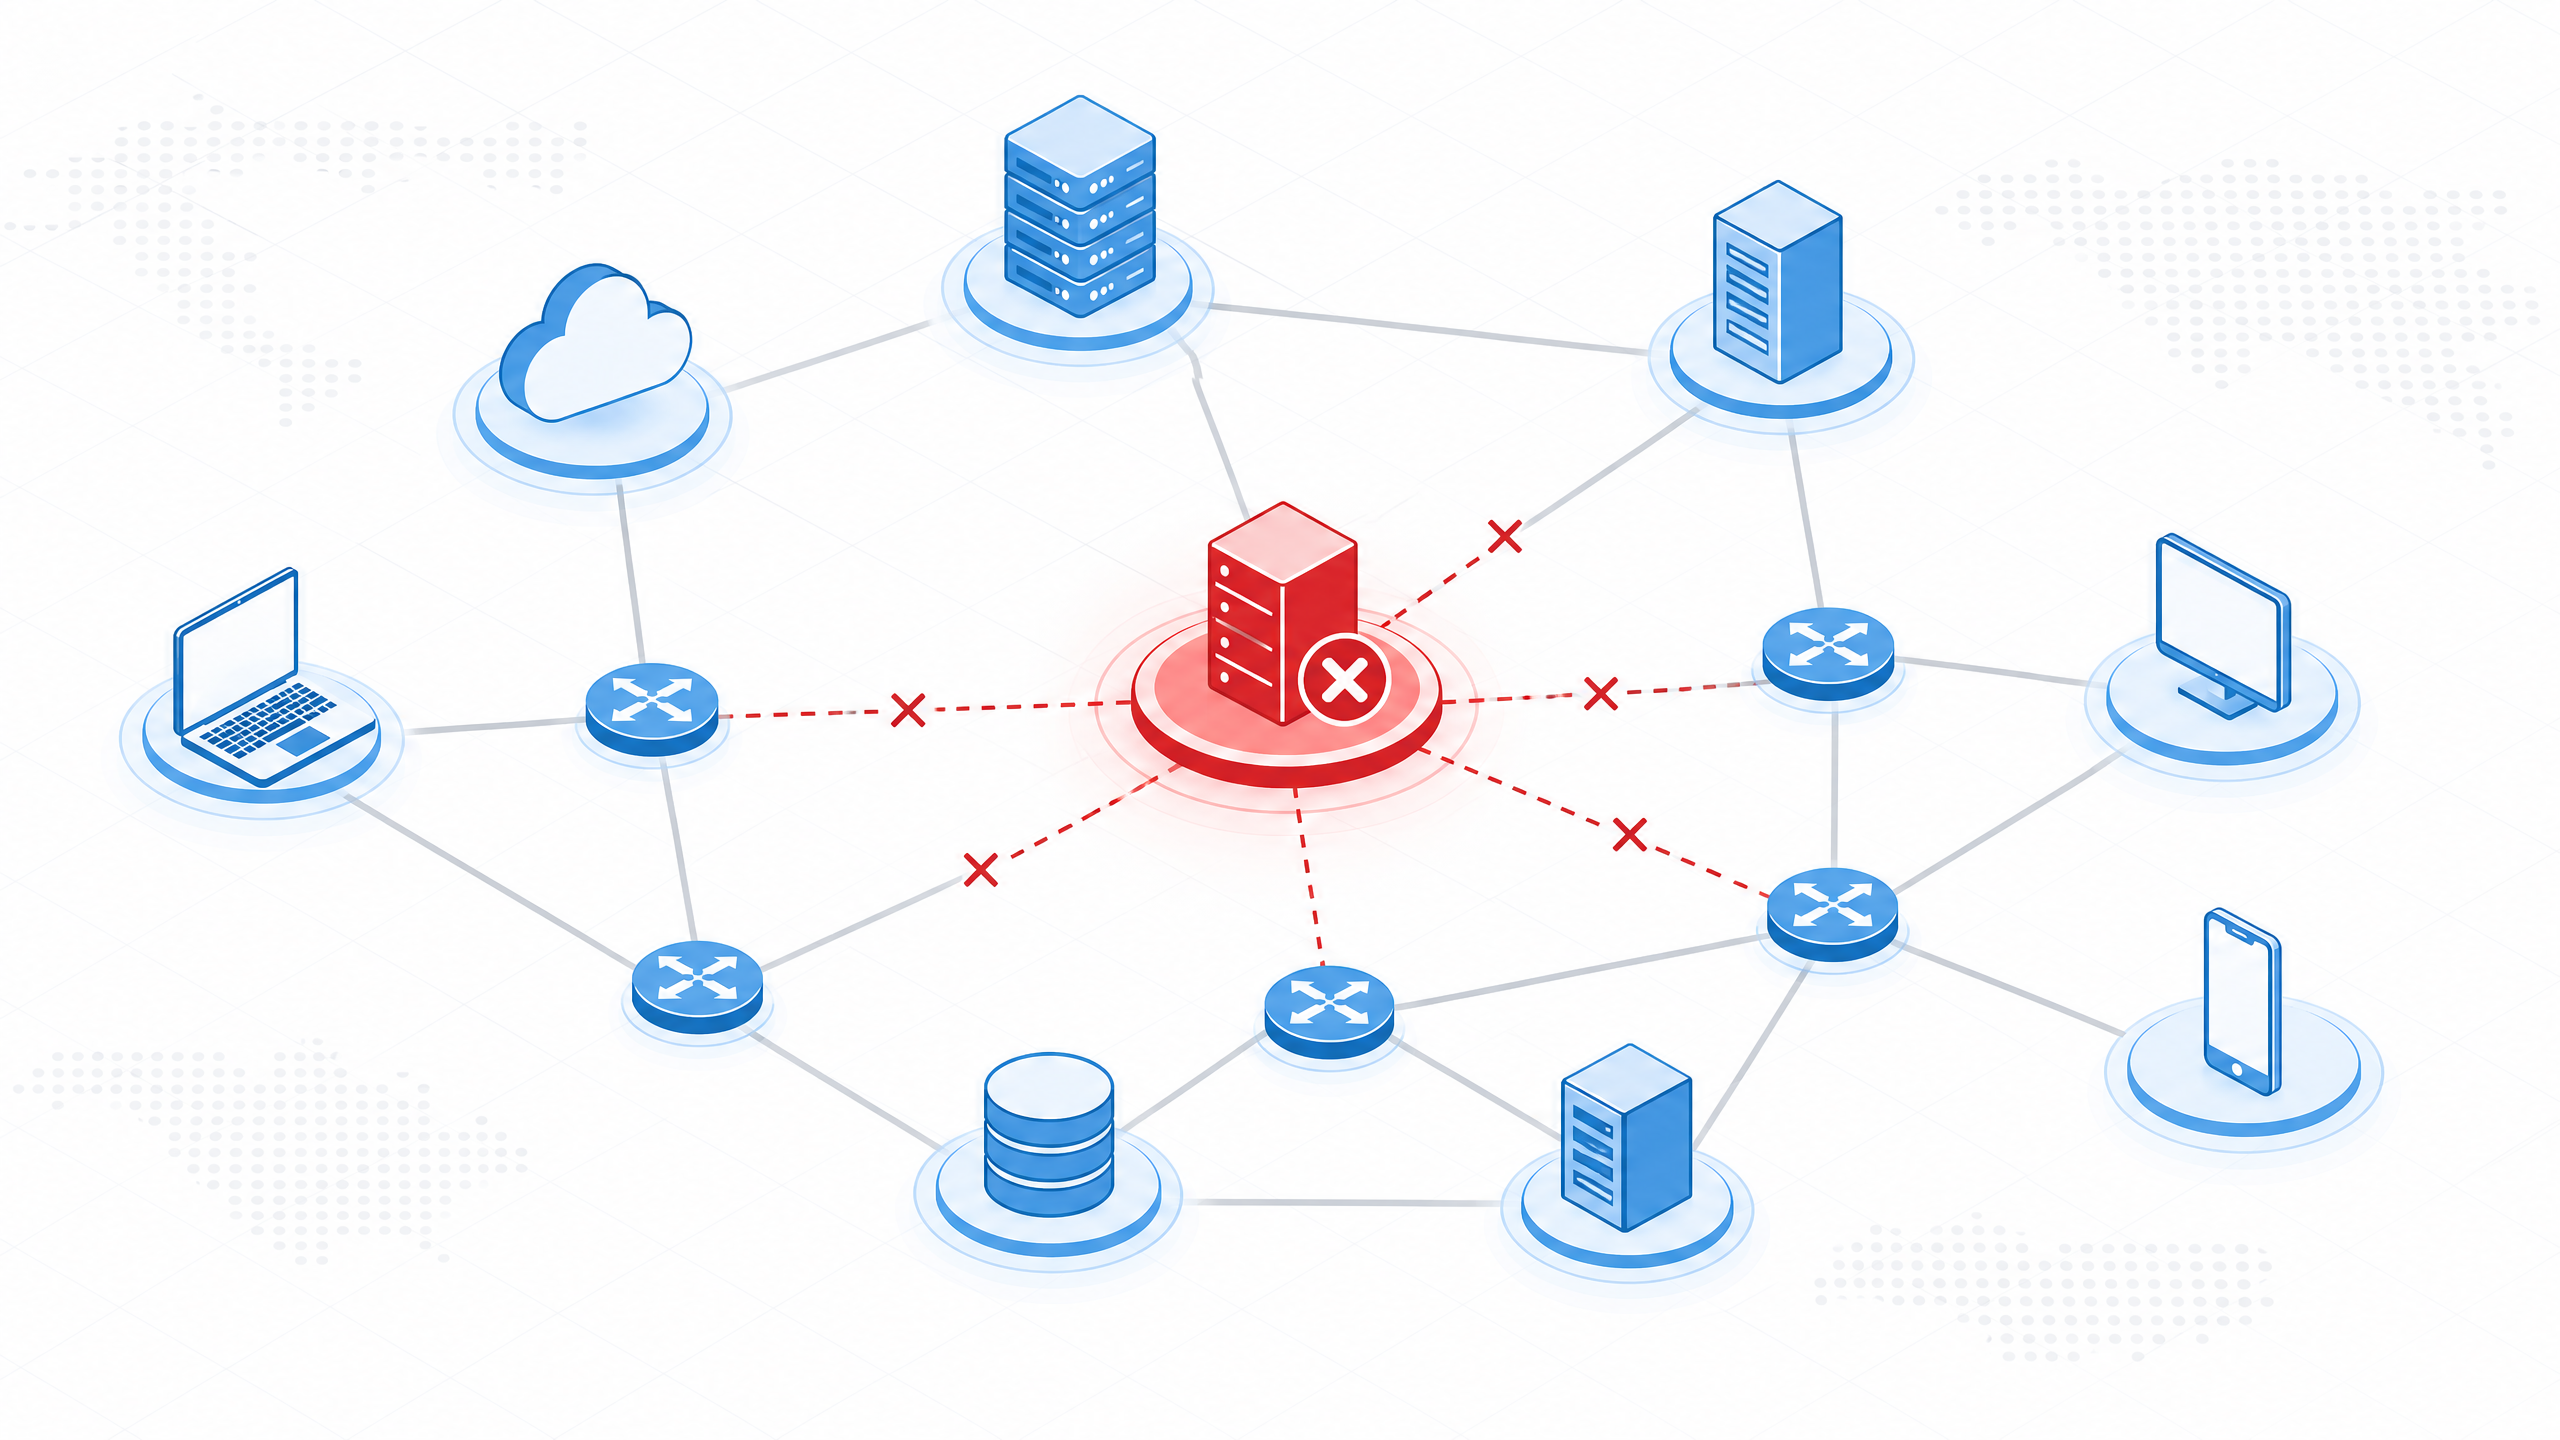
ウェブサイトがダウンしたときに何が起こるのか? インターネットの障害に関するシンプルなガイド
毎日、何百万人もの人々が同じ苛立たしい体験をしています:ウェブサイトやアプリを開こうとしても何も読み込まれません。ソーシャルメディアプラットフォーム、銀行ポータル、またはストリーミングサービスであっても、結果は同じ — 空白の画面、回転するホイール、または不可解なエラーメッセージです。しかし、ウェブサイトが「ダウン」するときに実際に何が起こるのか? そして、なぜそれがより頻繁に発生しているように見えるのでしょうか?
このガイドでは、インターネットの障害のメカニズムを平易な言葉で説明し、最も一般的な原因を解説し、世界の最も大きなテクノロジー企業でさえダウンタイムから免れない理由を理解する手助けをします。
問題の規模
インターネットの障害は、ほとんどの人が認識しているよりもはるかに一般的です。Cloudflareの2025年レビューによると、彼らの監視システムは、2025年中に世界中で174件の主要なインターネットの障害を検出しました — 週に3回以上の重大な中断があるという平均です。2025年1月から5月にかけて、グローバルなネットワークの障害が33.38%増加し、追跡されたインシデントは1,382件から1,843件に上昇しました。
その経済的影響も驚異的です。Uptime Instituteの調査によると、54%の組織が10万ドル以上のコストがかかる障害を経験し、41%の企業は1時間のダウンタイムで100万ドル以上の損失を報告しています。政府によるインターネットのシャットダウンだけで、2025年の世界経済に197億ドルの損失が出ています。
これらは抽象的な数字ではありません。大規模なプラットフォームがオフラインになると、実際の人々に影響を与えます — ツールにアクセスできない労働者、分単位で収入を失う企業、コミュニケーション、医療、日常生活のためにデジタルサービスに依存している個人がいます。
インターネットが実際にどのように機能するか(簡単に言うと)
ウェブサイトがダウンする理由を理解するには、まずそれらがどのようにして正常に稼働し続けるかを理解することが役立ちます。ウェブアドレスをブラウザに入力すると、驚くべき一連の出来事がミリ秒で発生します:
ステップ1: DNSルックアップ。 あなたのブラウザは、ドメインネームシステム(DNS)サーバーに、人間が読めるアドレス(例えば「statusisdown.com」)をコンピュータが理解できる数値のIPアドレスに変換するように求めます。DNSをインターネットの電話帳だと考えてください。
ステップ2: ルーティング。 あなたのリクエストは、インターネットを介して一連のルーターとスイッチを通じて移動し、ボーダーゲートウェイプロトコル(BGP)によって決定される経路に従います — 基本的にはインターネットのGPSナビゲーションシステムです。
ステップ3: サーバー処理。 あなたのリクエストは目的地のサーバー(またはより高い可能性としてデータセンターのサーバーのクラスター)に到達し、それを処理してウェブページのコンテンツを準備します。
ステップ4: コンテンツ配信。 レスポンスはあなたのデバイスに戻り、しばしばコンテンツデリバリーネットワーク(CDN)を通過します — サーバーのグローバルネットワークで、ユーザーに近い位置にコンテンツのコピーを保管し、より迅速な配信を提供します。
ステップ5: レンダリング。 あなたのブラウザはすべての要素(HTML、画像、スクリプト)を組み立ててページを表示します。
このチェーンの任意の単一のポイントでの失敗が、「ウェブサイトがダウンしている」という経験を引き起こすことがあります。インターネットは驚くほど回復力がありますが、同時に非常に複雑でもあり — 複雑さが失敗を生むのです。
インターネット障害の最も一般的な7つの原因
Uptime Institute、Cloudflare、ThousandEyesのデータに基づき、ウェブサイトやサービスがオフラインになる主な理由は次のとおりです:
1. サーバーの過負荷(トラフィックスパイク)
しかし、多くの人々が同時にサービスにアクセスしようとすると、そのインフラストラクチャが処理できる以上に人が集まります。これは、10,000台の車用に設計された高速道路に突然100,000台が集まるようなもので、全てが停止します。主要な製品の立ち上げ、速報ニュースイベント、バイラルなソーシャルメディアの瞬間などがこのタイプの障害を引き起こすことがよくあります。
2. DNS障害
DNSはインターネットのアドレス帳であるため、これが失敗すると、ブラウザは単にリクエストをどこに送信すればよいかわかりません。DNSの問題は、ダウンタイムの一般的かつ見落とされがちな原因です。期限切れのドメイン、不正確なDNSレコード、または誤設定されたネームサーバーが、実際のサーバーが正常に稼働しているにもかかわらず、ウェブサイト全体をアクセスできなくすることがあります。2025年10月のAWSの障害は、113のサービスに影響を与え、15時間以上続きましたが、これはDynamoDBのアップデートがDNSの障害に連鎖したことによって引き起こされました。
3. 設定ミス(人為的ミス)
Uptime Instituteは、手順に従わないスタッフの失敗が近年、以前よりもさらに大きな障害の原因となっていると報告しています。単一の誤設定された設定 — ルーティングテーブルの間違った番号、誤って削除されたデータベースエントリ、または正当なトラフィックをブロックするファイアウォールルール — が、全体のプラットフォームをダウンさせる可能性があります。2025年10月29日のAzure Front Doorの障害は、Office 365、Teams、およびXbox Liveに約9時間の影響を与えましたが、これは「意図しない設定の変更」が原因でした。
4. ハードウェアの故障
物理的な機器は故障します。ハードドライブが壊れ、メモリーチップが劣化し、ネットワークケーブルが損傷し、電源が焼き切れます。現代のデータセンターは冗長性(各コンポーネントのバックアップシステム)を構築していますが、ハードウェアの連鎖的な故障は、これらの保護機能を圧倒することがあります。電源は、Uptime Instituteによると、影響のあるデータセンターの障害の主要な原因です。
5. ソフトウェアのバグと悪い更新
サービスを改善するための更新が、逆にそれをダウンさせることがあります。最近の歴史における最も劇的な例は、CrowdStrikeのインシデントで、欠陥のあるFalconセキュリティの更新が850万台以上のMicrosoft Windowsデバイスに同時に影響を与えました。この単一のソフトウェアのバグは、フォーチュン500企業が約54億ドルの収益を失う原因となりました。
6. ネットワークとケーブルの損傷
グローバルなインターネットは物理的インフラに依存しています — 大陸間でデータを運ぶ海底光ファイバーケーブルを含みます。2025年9月6日、紅海の海底ケーブルが切断され、アジア、ヨーロッパ、中東間のインターネットトラフィックのほぼ25%が中断されました。陸上では、建設作業によって光ファイバーケーブルが偶然切断されることが、地域の障害の驚くほど一般的な原因となっています。
7. サイバー攻撃(DDoS)
分散型サービス拒否(DDoS)攻撃は、サイトに多くの偽のトラフィックを送り込むことで、本当のユーザーにサービスを提供できないようにします。これらの攻撃は、洗練され、規模が増大しています。中には、テラビット単位でのトラフィックを生成するものもあります。DDoS攻撃はデータを盗むことはありませんが、サービスを利用不可能にする効果があります — これが全体のポイントです。
障害がより複雑になっている理由
データの中で重要なトレンドが浮かび上がっています:個別のデータセンターの障害は頻度が減少していますが(過去3年間で障害を経験した施設は53%から50%に減少)、インターネットレベルの中断は増加しています。一つの分析では、「失敗はスタックの上に移行している — データセンターの電源からDNS、BGP、CDNのエッジに」と指摘されています。
これは、障害が単一のサーバーの故障によって引き起こされるのではなく、すべてを結びつける相互接続されたシステムの問題によって引き起こされることが増えていることを意味しています。AWSやAzureのようなクラウドプロバイダーに問題が発生すると、単一のウェブサイトだけでなく、そのインフラストラクチャに依存する数百のサービスに連鎖的に影響を与えることがあります。
人工知能の台頭も新たな負担を加えています。AIワークロードの需要の高まりは、電力と冷却システムに挑戦をもたらし、老朽化したグリッドインフラと断続的な再生可能エネルギーがデータセンターに新たな電力安定性のリスクを生んでいます。
サービスがダウンしたときにできること
障害に遭遇したとき、実践的なステップは次のとおりです:
それがあなたの問題だけでないことを確認してください。 Status Is Downのようなコミュニティ駆動の障害追跡サービスで、他の人が同じ問題を報告しているかどうかを確認してください。何千人もの人々が同時に問題を報告している場合、それはサービスの問題であって、あなたの問題ではありません。
自分の接続を確認してください。 ルーターを再起動したり、別のデバイスを試したり、Wi-Fiとモバイルデータを切り替えたりします。時には、ウェブサイトの障害に感じられるものが実際にはローカルな接続の問題であることがあります。
待ちましょう。 ほとんどの障害は数分から数時間以内に解決します。重大な障害の中央値の解決時間は、企業が迅速なインシデントレスポンスに投資するにつれて年々改善されています。
代替案を用意しておきます。 重要なワークフローのために、あらかじめバックアップツールを特定しておきます。主要なメールがダウンした場合、二次アカウントにアクセスする方法を知っておきます。ビデオ会議プラットフォームが失敗した場合は、バックアップオプションを用意しておきます。
情報を常に得るようにします。 ソーシャルメディアで障害追跡サービスのアカウント(例えば@Status_Is_Down)をフォローして、重大な中断についてのリアルタイムの通知を受け取ります。
結論
インターネットの障害はなくなることはありません。デジタルサービスへの依存が深まるにつれ、インフラがより相互接続されることで、単一の故障点の潜在的な影響範囲は増加する一方です。良いニュースは、業界が学び続けているということです — インターネットがより複雑になる一方で、障害の深刻度は全体として減少しています。
ウェブサイトがダウンする際に何が起こるのかを理解すると、経験が神秘的な苛立ちから理解可能なものに変わります。次回、ロードスピナーが決して解決しないのを見るとき、DNSからルーティング、サーバー、ケーブルまでのチェーンのどこかでリンクが切れていることを知っています。そしてどこかで、エンジニアリングチームが修正するためにすでに急いでいます。
依存しているサービスがダウンした瞬間を知りたいですか? Status Is Downアプリをダウンロードして、あなたの大切なサービスのためのパーソナライズされた障害アラートを設定しましょう。